У вас нет проблемы с моделью. У вас есть проблема с расходами или проблема с оборудованием, и большинство руководств никогда не говорят, что именно вас ждет. Каждая команда, начинающая использовать ИИ, через несколько месяцев сталкивается с одним и тем же выбором: облачный LLM против локального LLM, продолжать платить за токен через облачный API или купить оборудование и запустить модель самостоятельно. Оба варианта приемлемы. Неправильный выбор, не соответствующий вашим реальным потребностям, и приводит к значительным затратам.
В этом руководстве полностью отсутствует маркетинговый аспект. Вы получите реальные расчеты точки безубыточности, V-образную формулу.RAM Факты, которые действительно важны для каждого размера модели, что облачные провайдеры не указывают на своих страницах с ценами, и сколько стоят локальные установки, если учесть затраты на электроэнергию и ваше личное время.
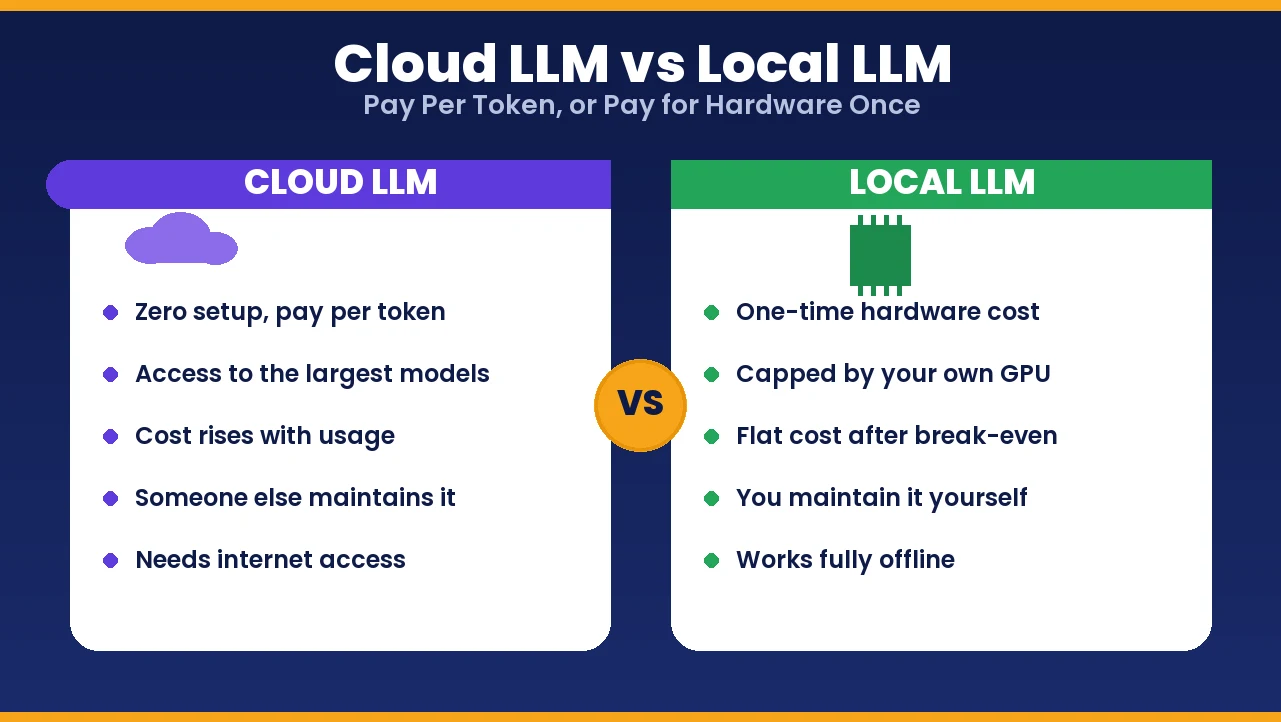
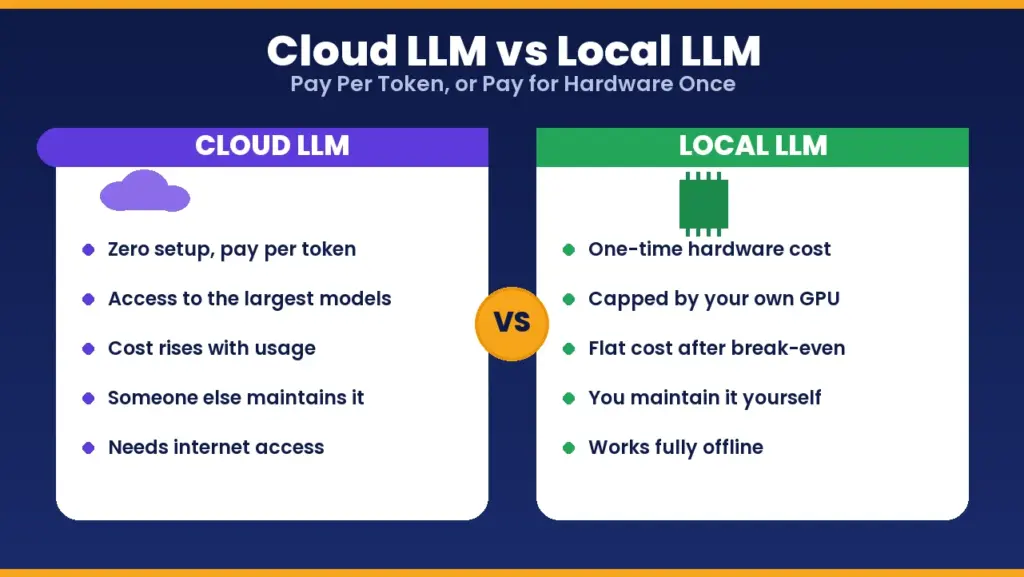
Сравнение облачных и локальных программ магистратуры: краткий обзор
Если вы прочитаете только один раздел, прочитайте этот.
| фактор | Клауд ЛЛМ | Местный магистр права |
|---|---|---|
| Первоначальная стоимость | $0 | Стоимость видеокарт часто составляет от 800 до 15 000 долларов и выше. |
| Стоимость при малом объеме | Самый дешевый вариант | Расточительное оборудование простаивает без дела. |
| Стоимость при высоком, стабильном объеме | Увеличение масштаба происходит линейно, что приводит к удорожанию. | После того, как оборудование окупится, ситуация стабилизируется. |
| Время установки | Минут | Часы в дни |
| Данные покидают вашу сеть. | Да | Нет |
| Потолок модельного качества | Доступ к крупнейшим моделям передовых разработок | Ограничение зависит от возможностей вашего оборудования. |
| Кто его обслуживает? | Провайдер | |
| Работает в автономном режиме | Нет | Да |
В споре между Cloud LLM и Local LLM ни один из столбцов не выигрывает однозначно. Остальная часть этого руководства существует потому, что фраза «зависит от обстоятельств» полезна только тогда, когда вы знаете, от чего именно она зависит.
Что на самом деле означают Cloud LLM и Local LLM?
Понимание различий между облачной и локальной языковой моделью начинается с определений. Облачная языковая модель — это любая большая языковая модель, которую вы вызываете через API, оплачивая каждый токен, при этом кто-то другой владеет и управляет графическими процессорами. Вы отправляете запрос, где-то в центре обработки данных запускает модель, и вы получаете ответ. Никакого оборудования, никакой настройки, кроме ключа API.
Локальная модель LLM — это модель с открытым исходным кодом, которую вы скачиваете и запускаете на контролируемом вами оборудовании, будь то ноутбук, настольный компьютер с игровой видеокартой или арендованный или собственный сервер. После загрузки модели её запуском занимаются такие инструменты, как Ollama или llama.cpp. Никакие введенные вами данные не покидают машину, на которой она запускается.
Путаница обычно возникает из-за третьего варианта, который объединяет оба: аренда сервера с графическим процессором в облаке и самостоятельный запуск на нем открытой модели. Это по-прежнему локальная модель LLM во всех отношениях, имеющих значение с точки зрения стоимости и конфиденциальности, просто на арендованном оборудовании вместо собственного. В этом руководстве под «локальной» понимается «модель, которую вы запускаете и контролируете», независимо от того, кому принадлежит сервер, на котором она размещена.
Расчет реальных затрат: где на самом деле находится точка безубыточности
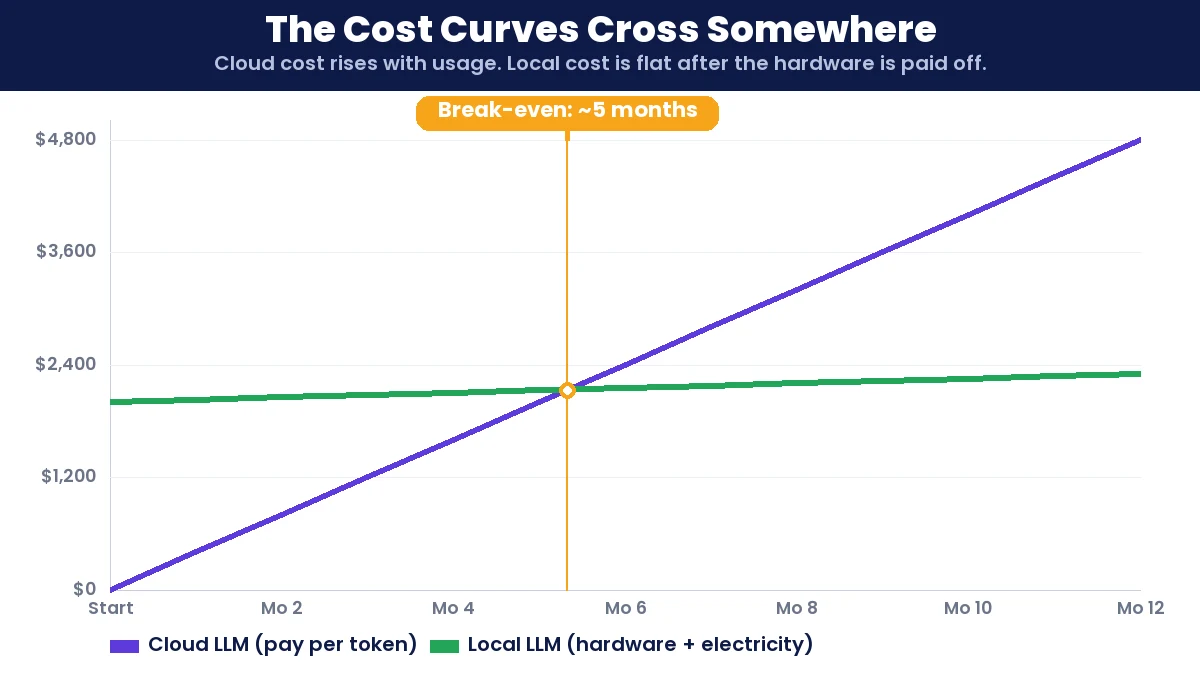
В сравнении стоимости Cloud LLM и Local LLM, цена в облаке рассчитывается за токен, поэтому ваш счет растет линейно с увеличением использования. Локальное оборудование — это фиксированная стоимость, которую вы оплачиваете один раз, поэтому ваша эффективная стоимость за токен снижается по мере увеличения использования. Где-то есть точка пересечения, и большинство людей определяют ее приблизительно, вместо того чтобы рассчитывать.
Все просто:
Месяцы, обеспечивающие точку безубыточности = Стоимость оборудования / (Ежемесячная стоимость облачного API - Ежемесячная стоимость локальных эксплуатационных расходов)
Ежемесячные эксплуатационные расходы в основном сводятся к оплате электроэнергии после покупки оборудования. Одна потребительская видеокарта, потребляющая от 350 до 450 ватт и работающая несколько часов в день, обычно добавляет к счету за электроэнергию от 10 до 40 долларов в месяц, в зависимости от местного тарифа на электроэнергию и того, сколько времени видеокарта фактически находится в режиме ожидания, а сколько — в режиме постоянной нагрузки.
| Ежемесячные расходы на облачный API | Ежемесячные местные расходы | Ежемесячная экономия при проживании в регионе. | Точка равновесия |
|---|---|---|---|
| $50 | $25 | $25 | 80 месяцев (не стоит того) |
| $150 | $25 | $125 | 16 месяцев. |
| $400 | $25 | $375 | 5.3 месяцев. |
| $ 1,000 + | $ 25 до $ 60 | $ 940 + | Около 2 месяцев |
Эти цифры варьируются в зависимости от провайдера, модели и региона, поэтому воспринимайте форму таблицы как урок, а не точные суммы в долларах. Закономерность сохраняется везде: легкое, эпизодическое использование почти никогда не оправдывает покупку оборудования. Интенсивное, предсказуемое, ежедневное использование обычно окупает оборудование в течение нескольких месяцев. Одно широко цитируемое эмпирическое правило указывает на реальный переходный период для серьезных рабочих нагрузок где-то около 50 миллионов токенов в месяц, хотя ваши результаты могут отличаться в зависимости от того, с какой облачной моделью вы сравнивали.
Одна деталь, которая меняет эти расчеты больше всего: с какой облачной моделью вы сравниваете. Дешевая, небольшая облачная модель может стоить в 100 раз меньше за токен, чем топовая модель с вычислительными возможностями от того же поставщика. Если ваша рабочая нагрузка не требует вычислительных возможностей передового уровня, переход на более дешевую облачную модель часто является лучшим первым шагом, чем покупка графического процессора вообще.
Аппаратная реальность: VRAM Вам это действительно нужно
Именно здесь большинство локальных планов по получению степени магистра права терпят крах. Люди покупают видеокарту, ориентируясь на название модели, а не на уровень квантизации, и в итоге получают либо избыточную карту, либо карту, которая вообще не может загрузить модель.
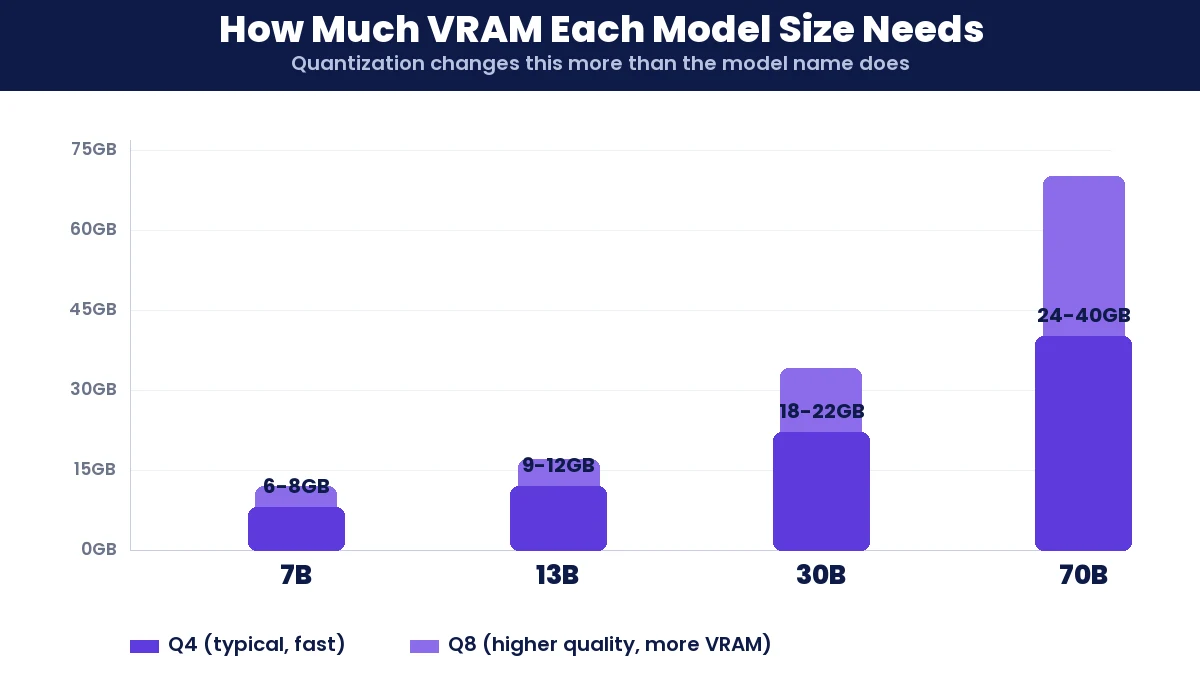
Выбор между облачным и локальным LLM в основном зависит от аппаратного обеспечения. Квантование сжимает веса модели, чтобы использовать меньше памяти, но с небольшим ухудшением качества. Q4 (4-битный) — это оптимальный вариант для локального запуска; Q8 обеспечивает лучшее качество, но требует примерно вдвое больше памяти; Q2 экономит больше памяти, но заметно ухудшает качество выходных данных.
| Размер модели | VRAM в 4 квартале (типичное значение) | VRAM на уровне Q8 (более высокое качество) | Реалистичная потребительская видеокарта |
|---|---|---|---|
| от 7Б до 8Б | От 6 до 8 ГБ | От 10 до 12 ГБ | RTX 4060 Ti 16 ГБ, RTX 3060 12 ГБ |
| от 13Б до 14Б | От 9 до 12 ГБ | От 16 до 18 ГБ | RTX 4070 Ti Super, RTX 4080 |
| от 30Б до 34Б | От 18 до 22 ГБ | От 32 до 36 ГБ | RTX 4090 24GB |
| 70B | От 24 до 40 ГБ | 70GB + | Две видеокарты RTX 4090 или аренда одного автовоза A100/H100. |
Оставьте от 1 до 2 ГБ свободного места сверх размера самого окна контекста и операционной системы, иначе размер модели будет превышать размер системного файла. RAM и очень медленный. Меньшая модель, которая полностью помещается в V.RAM Практически всегда будет казаться быстрее в использовании, чем более крупная модель, часть функций которой перенесена на более крупную модель. CPUдаже несмотря на то, что более крупная модель показывает более высокие результаты в тестах производительности.
Если покупка видеокарты в собственность пока нецелесообразна, почасовая аренда — это компромиссный вариант. Видеокарты потребительского класса, такие как RTX 4090, обычно доступны по цене значительно ниже доллара в час в специализированных облачных сервисах, в то время как цены на видеокарты для центров обработки данных быстро растут: A100 80GB обычно стоит от 1 до 2 долларов в час у бюджетных провайдеров и в несколько раз больше у крупных гипермасштабируемых провайдеров, а цены на H100 различаются почти в шесть раз у разных провайдеров для одного и того же чипа. Перед тем как выбрать провайдера, сравните цены, разница в ценах гораздо больше, чем большинство людей ожидает.
Задержка и производительность: кто на самом деле реагирует быстрее?
С точки зрения скорости, для большинства пользователей, работающих с отдельными пользователями, облачные и локальные LLM-модели выигрывают в пользу облачных решений. Облачные провайдеры запускают модели на оборудовании, которое большинство частных лиц и малых предприятий никогда не будут иметь в своей собственности, используя такие оптимизации, как пакетная обработка, спекулятивное декодирование и специализированные чипы для вывода результатов. Для пользователя, отправляющего запросы время от времени, хорошо оптимизированная облачная конечная точка обычно будет отвечать быстрее, чем локальная система, работающая с моделью аналогичного размера.
Преимущество локального развертывания в скорости заключается в контролируемой вами согласованности и параллельной обработке. Нет ограничений скорости, которые вы не установили бы сами, нет общей очереди с другими клиентами во время пика трафика и нет сетевых запросов, если приложение и модель находятся на одной машине. Для одной большой модели, например, модели с 70 миллиардами параметров, обычно требуется настоящий кластер с несколькими графическими процессорами, чтобы обеспечить пропускную способность облачного уровня, именно поэтому большинство локальных развертываний предпочитают использовать более мелкие и быстрые модели, а не гнаться за самыми крупными.
Конфиденциальность, соответствие нормативным требованиям и кто на самом деле видит ваши данные
Конфиденциальность — это единственный фактор при выборе между облачным и локальным LLM, где сравнение затрат перестаёт иметь значение. Если вы работаете с медицинскими картами пациентов, юридическими документами, неопубликованными финансовыми данными или чем-либо, что подпадает под требования о хранении данных, отправка этого текста в API третьей стороны — это не просто техническое, а политическое решение, и в некоторых регулируемых отраслях это просто запрещено, независимо от того, что обещает поставщик услуг не использовать ваши данные для обучения.
Запуск локальной модели позволяет хранить все запросы и ответы в пределах вашей собственной сети. Не нужно ничего проверять в соглашении с поставщиком об обработке данных, не нужно ничего объяснять аудитору о субподрядчике, которого вы не контролируете. Для команд, работающих в сфере здравоохранения, юриспруденции, финансов или смежных с государственным сектором областях, этот единственный фактор часто определяет решение еще до начала расчетов затрат.
Скрытые расходы, которые никто не указывает на странице с ценами.
В обоих случаях, при сравнении облачного и локального LLM, существуют издержки, которые проявляются только после принятия решения.
- Облако: Затраты растут вместе с успехом. В тот месяц, когда ваш продукт становится популярным, счет за API становится реальной статьей расходов, а не просто ошибкой округления. Выходные токены часто стоят дороже, чем входные, а за длительные диалоги, в которых постоянно отправляется история, взимается плата за каждый токен, каждый раз.
- Облако: Ограничения скорости и перебои в работе провайдера — это не дополнительные опции, а часть соглашения. Если у провайдера возникнет инцидент, то и у вашего продукта возникнет инцидент.
- Расположение: Электричество и охлаждение — это реальные и постоянные расходы, а не разовая покупка видеокарты. Видеокарта, работающая почти на полную мощность в течение нескольких часов в день, отразится на вашем счете за электроэнергию, а в жарком климате это также увеличит нагрузку на систему охлаждения.
- Расположение: Ваше время имеет свою цену. Проблемы с драйверами, обновления моделей, дисковое пространство для нескольких моделей разного веса и периодические сеансы устранения неполадок в 2 часа ночи — всё это реальная работа, даже если вам никто за неё не выставляет счёт.
- Расположение: Со временем оборудование изнашивается и требует замены, а видеокарта, купленная сегодня, не сможет так же комфортно работать с более мощными моделями следующего года.
Гибридный подход, который в итоге используют большинство команд.
В реальном мире противостояния облачных и локальных моделей управления обучением очень немногие команды, серьезно использующие ИИ, выбирают одну сторону и остаются верны ей. Распространенная схема, которая постоянно повторяется на практике, — это маршрутизация по задачам: облачные модели обрабатывают сложные логические рассуждения, анализ долговременного контекста или все, что выигрывает от использования самой крупной доступной модели, в то время как локальная модель обрабатывает большие объемы повторяющейся, конфиденциальной или чувствительной к задержкам работы, которая не требует самого мощного интеллекта.
Команда поддержки может использовать небольшую локальную модель для мгновенного и конфиденциального составления всех ответов, а затем отправлять в облачную модель для получения второго мнения только действительно сложные запросы. Команда разработчиков может использовать локальную модель для автозаполнения и шаблонного кода, сохраняя более широкое контекстное окно облачной модели для вопросов архитектуры. Соотношение почти никогда не бывает равным, но наличие обоих вариантов дает возможность использовать рычаг, когда узким местом становится либо стоимость, либо функциональность.
Какие открытые модели стоит запускать локально?
Выбор модели также является частью решения о том, что лучше: облачная или локальная программа магистратуры. Ситуация на рынке постоянно меняется, поэтому любая конкретная рекомендация имеет короткий срок действия, но полезно знать текущее состояние дел. Qwen модели, выпущенные с разрешения Apache Лицензия 2.0, неизменно входят в число самых скачиваемых моделей с открытым исходным кодом и удобно подходят для разных размеров. DeepSeek Модели, распространяемые под лицензией MIT, регулярно цитируются за высокую эффективность рассуждений и производительность кода в расчете на доллар вычислительных ресурсов. Меньшие семейства моделей, такие как... Гемма и Фита разработаны специально для эффективной работы на одном графическом процессоре ноутбука или даже CPU— всего лишь, жертвуя чистыми возможностями ради чего-то, что действительно работает везде.
Перед тем как выбрать тот или иной вариант лицензии для коммерческого продукта, обязательно ознакомьтесь с условиями её лицензирования. Apache И лицензионные соглашения 2.0, и MIT допускают коммерческое использование с минимальными ограничениями, но условия могут меняться между версиями моделей, поэтому внимательно изучите лицензионный файл конкретной версии, которую вы планируете использовать, вместо того, чтобы предполагать, что все семейство лицензируется одинаково всегда.
Распространенные ошибки, которых следует избегать
Эти ошибки, связанные с различием между Cloud LLM и Local LLM, снова и снова встречаются в реальных развертываниях.
- Покупка оборудования без предварительного измерения его использования. Сначала протестируйте облачный API в течение месяца и посмотрите на реальный счет, прежде чем рассчитывать стоимость покупки видеокарты на основе приблизительных данных.
- Размер графического процессора определяется названием модели, а не уровнем квантования. «Модель 70B» означает совершенно другое значение V.RAM В зависимости от того, запустите ли вы его во 2-м, 4-м или 8-м квартале.
- При расчете точки безубыточности затраты на электроэнергию не учитываются. Видеокарта, которая кажется бесплатной после покупки, на самом деле не бесплатна для ежедневной работы.
- Предположим, что все модели облачных вычислений стоят одинаково. Разница между бюджетной моделью и флагманской моделью логического вывода от одного и того же поставщика может составлять два порядка величины.
- Рассмотрение вопросов конфиденциальности как статьи расходов. Если нормативные требования предусматривают хранение данных внутри компании, то сравнение затрат становится неактуальным, решение уже принято.
Какой выбрать?
Выбирайте, исходя из ваших реальных потребностей и ограничений, а не из общего мнения о том, что «лучше».
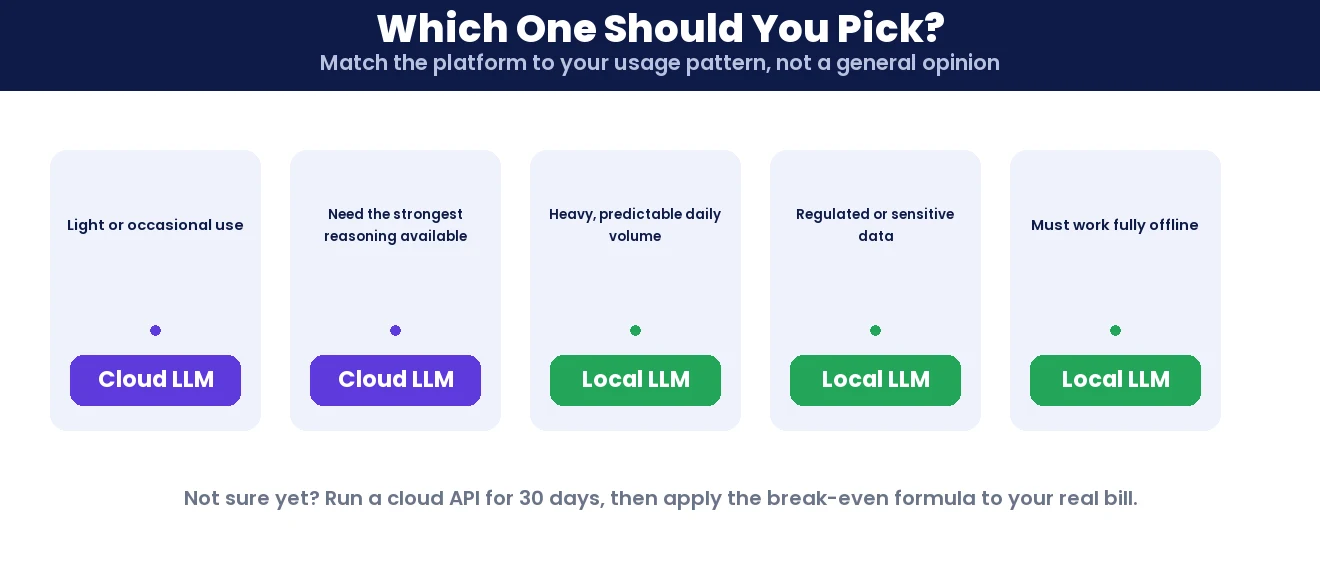
- Для нечастого использования или если вам нужна максимально мощная модель: Магистр облачных технологий. Покупка оборудования для эпизодического использования практически никогда не окупается.
- Интенсивное, предсказуемое, ежедневное использование в реальных условиях: Местный университет LLM. Точка безубыточности обычно достигается в течение нескольких месяцев, а не лет.
- Регулируемые или конфиденциальные данные: Обучение по программе LLM на местном уровне, независимо от расчетов стоимости.
- Продукт, который должен работать в автономном режиме или на периферии сети: Единственный работающий вариант — это обучение в магистратуре на местном уровне.
- Вы ещё не уверены: Начните с облачного API, отслеживайте фактическое использование токенов и выставляйте счета в течение 30-60 дней, а затем вернитесь к формуле безубыточности из этого руководства, используя реальные цифры, а не предположения.
Часто задаваемые вопросы (FAQ)
Действительно ли локальное обучение по программе LLM дешевле, чем обучение по облачной программе LLM?
Только при реальном объеме использования. При неинтенсивном использовании облачный API почти всегда дешевле, потому что не нужно покупать дополнительное оборудование. Точка перехода зависит от ваших ежемесячных расходов, но интенсивное, предсказуемое использование часто окупает графический процессор за несколько месяцев, в то время как при эпизодическом использовании он может никогда не окупиться.
Сколько VRAM Нужно ли мне проходить обучение по программе LLM в местном университете?
Это зависит от размера модели и уровня квантования, а не только от названия модели. Модель 7B с 4-битным квантованием помещается в 6-8 ГБ памяти.RAMДля модели 13B требуется примерно от 9 до 12 ГБ памяти, а для модели 70B — от 24 до 40 ГБ и более, в зависимости от выбранного уровня квантования.
Можно ли запустить локальный LLM без графического процессора?
Да, более компактные модели могут работать на CPU В одиночку, хотя и заметно медленнее. Семейства моделей, созданные для этого, такие как более мелкие версии Gemma или Phi, специально разработаны для приемлемой работы на ноутбуке. CPU или скромный графический процессор.
Законно ли использовать облачную платформу для обучения в магистратуре (LLM) с конфиденциальными данными компании?
Это зависит от вашей отрасли и конкретного соглашения с поставщиком. Многие регулируемые отрасли, такие как здравоохранение и финансы, ограничивают или запрещают отправку определенных типов данных сторонним обработчикам, независимо от того, что обещает поставщик в отношении обработки данных, поэтому проверьте свои требования к соблюдению нормативных требований, прежде чем отправлять конфиденциальные данные в любой облачный API.
Какова точка безубыточности при покупке графического процессора вместо оплаты облачного API?
Разделите стоимость оборудования на разницу между вашими ежемесячными расходами на облачный API и ежемесячными расходами на локальные вычисления, в основном, на электроэнергию. Команда, тратящая 400 долларов в месяц на облачный API и переходящая на оборудование, эксплуатация которого обходится в 25 долларов в месяц, обычно окупает затраты на графический процессор стоимостью 2,000 долларов чуть более чем за пять месяцев.
Насколько хорошо локальные LLM-системы работают по сравнению с облачными LLM-системами, такими как GPT или Claude?
Крупнейшие облачные модели, находящиеся на переднем крае современных технологий, в настоящее время превосходят по производительности все, что можно запустить на домашнем оборудовании, но разрыв быстро сократился. Многие открытые локальные модели теперь достаточно хорошо справляются с повседневными задачами, такими как составление черновиков, обобщение и помощь в программировании, так что разница имеет значение только для самых сложных задач логического мышления.
Могу ли я переключаться между облачными и локальными LLM-модулями для выполнения различных задач?
Да, и именно на таком гибридном подходе в итоге останавливается большинство команд. Распространенная схема заключается в перенаправлении рутинной, объемной или конфиденциальной работы в локальную модель, а сложных задач или задач с длительным контекстом — в облачную модель.
Что произойдет, если мое локальное оборудование LLM выйдет из строя или закончится его емкость?
В отличие от облачного API, здесь нет автоматического переключения на резервный сервер, поэтому отказ оборудования означает простой до тех пор, пока оно не будет отремонтировано или заменено. Многие команды, использующие локальные модели в производственной среде, сохраняют облачный API в качестве запасного варианта именно по этой причине.
Заключение
Сравнение облачных и локальных решений LLM — это не столько противостояние философий, сколько два инструмента, решающие разные задачи. Облачные решения выигрывают за счет гибкости, доступа к самым крупным моделям и отсутствия необходимости в настройке. Локальные же выигрывают по стоимости в реальном масштабе, конфиденциальности и возможности работы без подключения к интернету. Большинство команд, взвешивающих облачные и локальные решения LLM, в итоге выбирают оба варианта, ориентируясь на конкретные задачи, а не ограничиваясь одним выбором и постоянной защитой. Прежде чем что-либо покупать, произведите расчет точки безубыточности на собственных данных и пересматривайте его каждые несколько месяцев, потому что обе стороны этого сравнения постоянно меняются.