Un DataFrame de Pandas es una estructura de datos tabular bidimensional en Python con filas y columnas etiquetadas, diseñada para la limpieza, el análisis y la transformación rápidos de datos. Imagínelo como una hoja de cálculo en memoria con potentes funciones de indexación, selección y agregación.
A continuación, verás una explicación de Pandas DataFrame con ejemplos que puedes copiar, ejecutar y adaptar. Pandas DataFrame es el componente fundamental del análisis de datos en Python. Facilita y optimiza la importación, limpieza, transformación y resumen de datos.
En esta guía, explicaré qué es un DataFrame, cómo crearlo y cómo trabajar con él, respaldado por ejemplos prácticos y mejores prácticas de proyectos reales de análisis e ingeniería.
¿Qué es un marco de datos de Pandas?
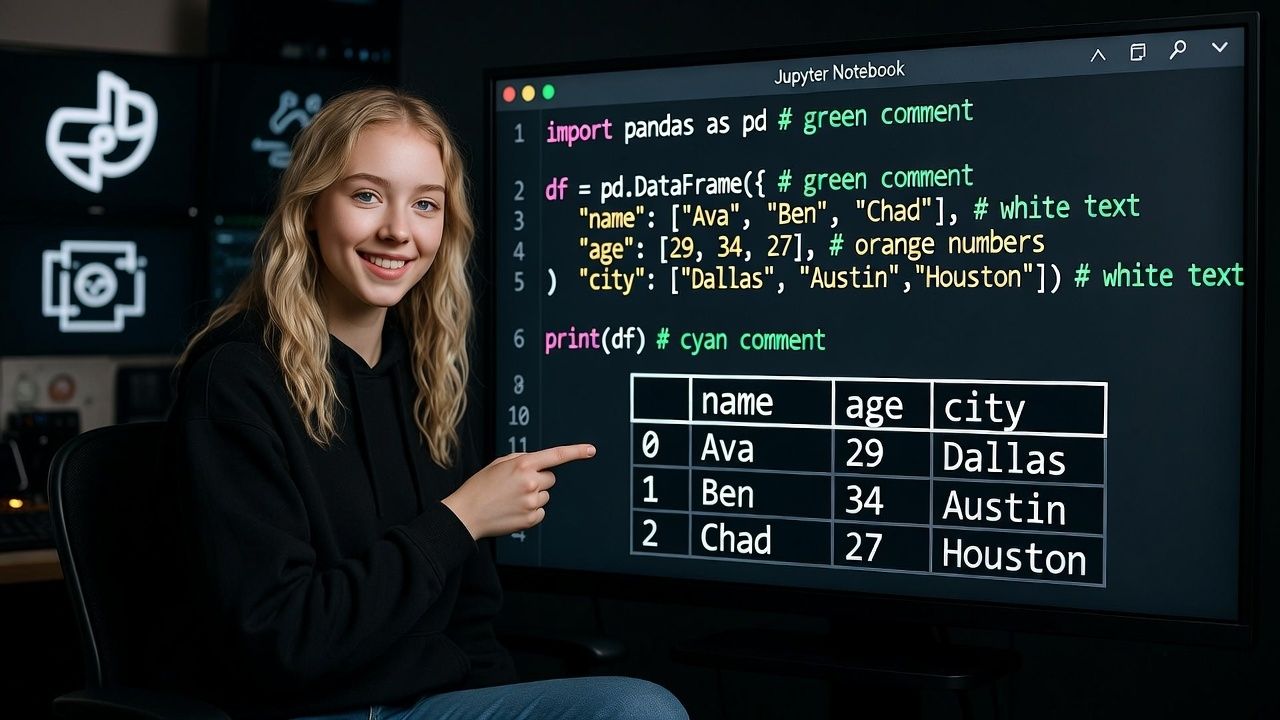
Un Pandas DataFrame es una tabla etiquetada en 2D donde:
- Las columnas pueden contener diferentes tipos de datos (int, float, string, datetime, categórico).
- Filas y columnas tienen etiquetas (nombres de índice y columnas) para un acceso rápido y legible para humanos.
- Operaciones vectorizadas Permitir operaciones aritméticas rápidas y transformaciones entre columnas.
Los DataFrames se basan en Series (matrices unidimensionales) y se integran estrechamente con NumPy para optimizar el rendimiento. En comparación con las listas simples de Python o el manejo de archivos CSV, los DataFrames ofrecen herramientas integradas para valores faltantes, uniones, operaciones de grupo y análisis.
Pandas DataFrame vs. Series vs. Matriz NumPy
- serie: Matriz etiquetada 1D (como una sola columna).
- Marco de datos: Tabla etiquetada 2D de múltiples series alineadas por índice.
- Matriz NumPy: Matriz n-dimensional rápida y homogénea (sin etiquetas de columnas ni tipos mixtos).
Elija DataFrame para datos tabulares de tipo mixto y etiquetados; matrices NumPy para datos numéricos puros del mismo tipo; Series para columnas individuales o características.
Cómo crear un DataFrame (con ejemplos)
1. De diccionarios o listas de Python
import pandas as pd

data = {
    "name": ["Ava", "Ben", "Chad"],
    "age": [29, 34, 27],
    "city": ["Dallas", "Austin", "Houston"]
}

df = pd.DataFrame(data)
print(df)
Esta es la forma más sencilla de crear un DataFrame pequeño para pruebas o demostraciones.
2. Desde CSV, Excel, JSON o SQL
# CSV
df = pd.read_csv("sales.csv")

# Excel
df_xls = pd.read_excel("sales.xlsx", sheet_name="Q1")

# JSON
df_json = pd.read_json("data.json")

# SQL (requires an engine, e.g., SQLite or PostgreSQL)
from sqlalchemy import create_engine
engine = create_engine("sqlite:///app.db")
df_sql = pd.read_sql("SELECT * FROM orders", engine)
Utilice estos lectores en proyectos reales, especialmente para conjuntos de datos y procesos de producción más grandes.
3. Desde matrices o series NumPy
import numpy as np
arr = np.array([[1, 2], [3, 4]])
df_np = pd.DataFrame(arr, columns=["a", "b"])
print(df_np)
Cuando los datos comienzan siendo numéricos y sin etiquetas, agregue nombres de columnas inmediatamente para lograr claridad y compatibilidad posterior.
Seleccionar, indexar y filtrar datos
.loc frente a .iloc
# Sample setup
df = pd.DataFrame({
    "name": ["Ava", "Ben", "Chad", "Dana"],
    "age": [29, 34, 27, 31],
    "score": [85, 92, 88, 79]
}, index=["u1", "u2", "u3", "u4"])

# Label-based selection with .loc
print(df.loc["u2", "score"])        # row label "u2", column "score"
print(df.loc["u1":"u3", ["name","age"]])  # slice by labels

# Position-based selection with .iloc
print(df.iloc[1, 2])                # second row, third column (0-based)
print(df.iloc[0:2, 0:2])            # top-left 2x2 block
Filtrado y consulta booleanos
# Filter rows
adults = df[df["age"] >= 30]
high_scorers = df[(df["score"] >= 90) & (df["age"] < 35)]

# Using query (readable for complex filters)
top = df.query("score >= 90 and age < 35")
Prefiera máscaras booleanas vectorizadas o cadenas de consulta para mayor velocidad y legibilidad en lugar de bucles.
Operaciones comunes de DataFrame
Agregar, renombrar y eliminar columnas
# Create or transform columns
df["age_group"] = pd.cut(df["age"], bins=[0, 29, 100], labels=["Young", "Adult"])
df = df.rename(columns={"score": "exam_score"})
df = df.drop(columns=["age_group"])
Ordenación y clasificación
df_sorted = df.sort_values(by=["exam_score", "age"], ascending=[False, True])
df["rank"] = df["exam_score"].rank(ascending=False, method="dense")
GroupBy y agregación
sales = pd.DataFrame({
    "region": ["US","US","EU","EU","APAC"],
    "rep": ["A","B","C","D","E"],
    "revenue": [100, 130, 90, 120, 150]
})

summary = sales.groupby("region")["revenue"].agg(["count","sum","mean","max"])
print(summary)
GroupBy divide los datos en grupos, aplica funciones y combina resultados. Es la herramienta ideal para informes y resúmenes de estilo BI.
Aplicar vs vectorización
# Prefer vectorized operations
df["double_score"] = df["exam_score"] * 2

# If you must use apply, keep it simple (it’s slower)
df["pass_fail"] = df["exam_score"].apply(lambda x: "Pass" if x >= 80 else "Fail")
Las operaciones vectorizadas aprovechan rutinas optimizadas para C y son significativamente más rápidas que las aplicadas por filas.
Manejo de datos y tipos faltantes
Detectar, completar o eliminar valores faltantes
df.isna().sum()                      # count of NaNs per column
df_filled = df.fillna({"exam_score": 0})
df_dropped = df.dropna(subset=["exam_score"])
Utilice estrategias específicas del dominio: rellene hacia adelante las series de tiempo, rellene con medianas para datos numéricos sesgados o elimine cuando sea apropiado.
Corregir dtypes para velocidad y memoria
# Convert strings that look like numbers
df["exam_score"] = pd.to_numeric(df["exam_score"], errors="coerce")

# Categorical for repeated strings
df["name"] = df["name"].astype("category")

# Parse datetimes
df["date"] = pd.to_datetime(df["date"], errors="coerce")
Los tipos d adecuados (especialmente los categóricos y de fecha y hora) reducen la memoria y permiten un filtrado y una agrupación más rápidos.
Fusionar, unir y concatenar
Combine múltiples DataFrames como si fueran uniones SQL o tablas apiladas.
customers = pd.DataFrame({
    "cust_id": [1,2,3],
    "name": ["Ava","Ben","Chad"]
})
orders = pd.DataFrame({
    "order_id": [101,102,103],
    "cust_id": [1,1,3],
    "amount": [39.5, 12.0, 55.0]
})

# SQL-style inner join on a key
merged = pd.merge(orders, customers, on="cust_id", how="inner")

# Concatenate rows (stack)
stacked = pd.concat([orders, orders], ignore_index=True)

# Join by index
customers_i = customers.set_index("cust_id")
orders_i = orders.set_index("cust_id")
joined = customers_i.join(orders_i, how="left")
Seleccione "inner" para la intersección, "left" para conservar todos los datos de la tabla izquierda y "outer" para la unión completa. Siempre valide la unicidad de la clave para evitar la duplicación.
E/S y serialización: CSV vs. Parquet vs. Feather
CSV es legible, pero grande y lento de analizar. Parquet y Feather son formatos binarios de columnas que se cargan más rápido y consumen menos disco.
# CSV
df.to_csv("data.csv", index=False)

# Parquet (requires pyarrow or fastparquet)
df.to_parquet("data.parquet", index=False)

# Feather (fast for Python-R interchange)
df.to_feather("data.feather")
Para análisis a escala, prefiera Parquet o Feather para reducir la sobrecarga de E/S y acelerar los procesos.
Consejos de rendimiento para grandes marcos de datos
- Leer en fragmentos: Utilice read_csv con chunksize para archivos grandes.
- Números abatidos: Convierte float64/int64 a float32/int32 cuando sea seguro.
- Utilice dtype categórico para cadenas repetidas (por ejemplo, códigos de país, ID de producto).
- Prefiera operaciones vectorizadas y agregaciones integradas en lugar de bucles.
- Filtrar temprano, seleccionar sólo las columnas necesarias (usecols=…).
- Almacene en caché los resultados intermedios en Parquet para realizar ejecuciones más rápidas.
# Example: chunked CSV processing
import pandas as pd

total = 0
for chunk in pd.read_csv("events.csv", usecols=["user_id","amount"], chunksize=500_000):
    chunk["amount"] = pd.to_numeric(chunk["amount"], errors="coerce")
    total += chunk["amount"].sum(skipna=True)
print(total)
Trabajar con millones de filas se beneficia de Potentes capacidades de procesamiento y E/S. Si ejecuta scripts de Jupyter, Airflow o ETL en la nube, un VPS escalable con almacenamiento NVMe le ayudará. YouStable, proporcionamos VPS SSD/NVMe y manageInstancias en la nube adecuadas para flujos de trabajo de datos, para que sus trabajos de Pandas finalicen de forma más rápida y confiable.
Ejemplos del mundo real que puedes reutilizar
Análisis de registros web (filtrado y agrupación)
import pandas as pd

logs = pd.read_csv("access.log.csv", usecols=["ip","status","bytes","ts"])
# Parse timestamp and filter errors
logs["ts"] = pd.to_datetime(logs["ts"])
errors = logs[logs["status"].isin([500, 502, 503, 504])]

# Error rate by minute
rate = (errors
        .groupby(pd.Grouper(key="ts", freq="1min"))
        .size()
        .rename("errors_per_min"))
print(rate.tail())
Análisis de ventas (uniones y agregación)
orders = pd.read_csv("orders.csv")           # order_id, cust_id, amount, date
customers = pd.read_csv("customers.csv")     # cust_id, segment

df = pd.merge(orders, customers, on="cust_id", how="left")
df["date"] = pd.to_datetime(df["date"])

# Revenue by segment and month
monthly = (df
    .groupby([pd.Grouper(key="date", freq="MS"), "segment"])["amount"]
    .sum()
    .reset_index()
    .sort_values(["date", "segment"]))
print(monthly.head())
Estos patrones aparecen en los paneles de negocios, en la detección de anomalías y en la planificación de la capacidad en todos los equipos de ingeniería.
Lista de verificación de mejores prácticas
- Nombra las columnas de forma clara y coherente (se recomienda usar snake_case).
- Establezca un índice cuando transmita identidad o tiempo (por ejemplo, establezca un índice de fecha y hora para series de tiempo).
- Validar uniones: comprobar la unicidad de la clave y el número de filas después de las fusiones.
- Utilice Parquet para grandes conjuntos de datos intermedios y CSV para intercambio con humanos.
- Convierta los dtypes anticipadamente para evitar sorpresas y reducir la memoria.
- Favorecer la vectorización y los métodos integrados; evitar la aplicación por filas en bucles ajustados.
- Escriba código reproducible: fije versiones y genere aleatoriedad cuando sea necesario.
Preguntas Frecuentes
¿Para qué se utiliza un DataFrame de Pandas?
Un DataFrame de Pandas se utiliza para cargar, limpiar, transformar, analizar y exportar datos tabulares. Admite filtrado rápido, uniones, agregaciones, remuestreo de series temporales e ingeniería de características para pipelines de aprendizaje automático.
¿Cómo creo un DataFrame en Pandas?
Puedes crear uno a partir de diccionarios/listas (pd.DataFrame), archivos como CSV o Excel (pd.read_csv, pd.read_excel), JSON (pd.read_json) o SQL (pd.read_sql). Para datos numéricos, convierte desde matrices de NumPy y añade nombres de columna para facilitar la lectura.
¿Cuál es la diferencia entre .loc y .iloc?
.loc selecciona por etiqueta (nombres de índice/columna), mientras que .iloc selecciona por posición entera. Use .loc cuando conozca las etiquetas y .iloc para segmentación posicional y desplazamientos numéricos.
¿Cómo puedo gestionar los valores faltantes en un DataFrame?
Use isna para detectar, fillna para imputar (con valores de media, mediana, moda o específicos del dominio) y dropna para eliminar filas o columnas. Para series temporales, suele ser conveniente usar el relleno hacia adelante o hacia atrás, pero valide con las reglas de su dominio.
¿Cómo puedo acelerar Pandas con conjuntos de datos grandes?
Lea en fragmentos, convierta tipos numéricos, use dtypes categóricos, filtre temprano y cambie a Parquet. Para cargas de trabajo mayores que la memoria, considere Dask o Polars. Ejecutando en VPS con respaldo NVMe o nodos en la nube (como los de YouStable) también puede reducir los cuellos de botella de E/S y acelerar los trabajos.
Con estos fundamentos y ejemplos, podrá usar con confianza los DataFrames de Pandas para la manipulación de datos, el análisis y el ETL de producción. Mantenga su código claro, sus tipos de datos correctos y sus formatos de almacenamiento optimizados para un rendimiento óptimo.