Las respuestas lentas, los fallos aleatorios y los modelos que fallan cuando más importan suelen deberse a recursos limitados del sistema local. Los LLM modernos requieren estabilidad. RAM, gran capacidad de procesamiento y tiempo de actividad constante, algo que la mayoría de las configuraciones personales no pueden manejar de manera eficiente, lo que conlleva un rendimiento inestable y frecuentes problemas de ejecución.
Una solución más fiable consiste en ejecutar LLM localmente en un VPS, donde los recursos dedicados y una mayor disponibilidad crean un entorno estable. Esta configuración mejora el rendimiento, reduce los fallos y admite cargas de trabajo reales. Con la configuración adecuada, su LLM funcionará de forma fluida, consistente y sin interrupciones innecesarias.
¿Qué significa ejecutar LLM localmente en un VPS?
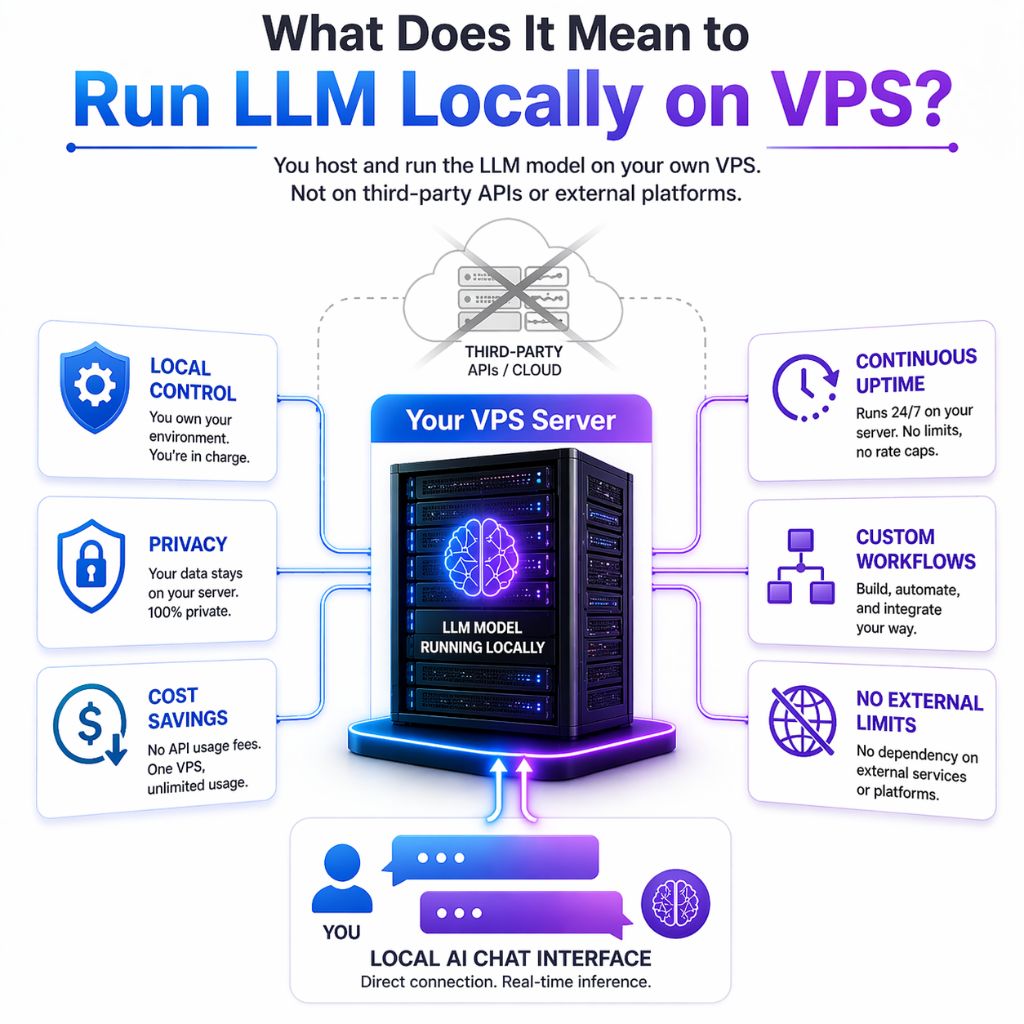
Ejecutar un modelo LLM localmente en un VPS significa alojar y ejecutar el modelo en tu propio entorno de servidor, en lugar de depender de API de terceros o plataformas externas. Aunque el servidor sea remoto, funciona como tu sistema personal, donde controlas cómo se instala, configura y utiliza el modelo sin limitaciones externas.
Esta configuración te brinda control total sobre el rendimiento, la privacidad y el costo.
Puede manage Proteja sus datos de forma segura, evite los cargos recurrentes de la API y ejecute el modelo de forma continua para la automatización o aplicaciones del mundo real.
Resulta especialmente útil cuando se desea una salida estable, flujos de trabajo personalizables y un entorno fiable que no dependa de servicios externos ni de límites de uso.
¿Por qué usar un VPS en lugar de un sistema local?
Un sistema local puede maneja pruebas básicas, pero rápidamente alcanza sus límites cuando comienzas a ejecutar LLM regularmente. La mayoría de las máquinas personales tienen problemas con las limitaciones RAM, promedio CPUy sin GPU dedicada, lo que provoca respuestas lentas, bloqueos o fallos en la ejecución. Además, todo depende de que el dispositivo esté activo, por lo que cualquier apagado o interrupción detiene directamente los flujos de trabajo.
Un VPS proporciona un entorno mucho más fiable y escalable para ejecutar LLM. Funciona de forma continua, ofrece recursos dedicados y permite actualizarlo. CPU, RAMo almacenamiento a medida que crece su carga de trabajo. Esto hace que su configuración sea más estable, rápida y adecuada para el uso en el mundo real. Elegir una plataforma VPS consistente como YouStable Mejora aún más el rendimiento al reducir el tiempo de inactividad y gestionar cargas de trabajo pesadas sin interrupciones.
Requisitos mínimos de VPS para ejecutar LLM
Si te estás iniciando en los modelos LLM o trabajas con modelos más pequeños (de entre 1 y 7 millones de parámetros), no necesitas un servidor de gama alta. Una configuración básica de VPS es suficiente para ejecutar estos modelos para pruebas, aprendizaje y tareas de automatización sencillas. Sin embargo, incluso los modelos pequeños requieren un entorno estable, por lo que elegir la configuración mínima adecuada es importante para evitar ralentizaciones o fallos inesperados.
Explicación de los requisitos básicos
- CPU: 4–8 núcleos
Un sistema multinúcleo moderno CPU ayuda manage procesos del sistema y ejecución del modelo. Si bien los LLM dependen más de la GPU para la velocidad, un modelo decente CPU Garantiza que el sistema funcione sin problemas ni cuellos de botella.
- AM: 8–16 GB
RAM Esto es fundamental, ya que el modelo necesita cargarse en la memoria durante su ejecución. Con menos de 8 GB, es posible que experimente fallos al iniciar o bloqueos. 16 GB proporcionan mayor estabilidad para un rendimiento más fluido.
- Almacenamiento: SSD de 50 GB (recomendado)
El almacenamiento rápido, como las unidades SSD, garantiza una carga de modelos más rápida y un mejor acceso a los datos. Los discos duros tradicionales (HDD) pueden ralentizar significativamente el proceso, especialmente al trabajar con archivos grandes.
- GPU: Opcional (4–8 GB VRAM (si está disponible)
No se requiere una GPU para modelos pequeños, pero puede mejorar significativamente la velocidad de respuesta. Sin GPU, el modelo se ejecutará en CPU, que es más lento pero aún utilizable para tareas básicas.
Qué puedes esperar de esta configuración
Esta configuración funciona bien para:
- Aprender cómo funcionan los LLM
- Ejecutando modelos pequeños
- Pruebas de indicaciones y flujos de trabajo
- Tareas básicas de automatización.
Sin embargo, el rendimiento será limitado. Es posible que notes respuestas más lentas, especialmente sin aceleración por GPU. Esta configuración no es ideal para gestionar múltiples solicitudes ni para ejecutar modelos complejos.
Configuración de VPS recomendada para un rendimiento óptimo
Para modelos LLM de tamaño mediano (con entre 7 y 13 millones de parámetros), una configuración de VPS equilibrada es fundamental para mantener tanto la velocidad como la estabilidad. A este nivel, el modelo requiere suficiente memoria y potencia de procesamiento para funcionar correctamente, especialmente si se planea usarlo para automatización, API o cargas de trabajo habituales.
- CPU: 8–16 núcleos
Un mas fuerte CPU ayuda manage Los procesos se ejecutan en segundo plano y garantizan una ejecución fluida y sin demoras.
- RAM: 16–32GB
Esta capacidad proporciona suficiente memoria para cargar y ejecutar modelos de forma fiable, reduciendo las posibilidades de fallos o ralentizaciones.
- Almacenamiento: SSD NVMe
El almacenamiento NVMe mejora la velocidad de acceso a los datos y reduce el tiempo de carga de los modelos en comparación con las unidades SSD estándar.
- GPU: 12–24 GB VRAM
En esta etapa, la GPU se vuelve importante para lograr una inferencia más rápida y un mejor rendimiento general.
Con esta configuración, puede esperar respuestas más rápidas, una ejecución estable y la capacidad de manejar múltiples tareas de manera eficiente. Muchas plataformas VPS confiables, como YouStable, proporcionar configuraciones que se ajusten a estos requisitos, lo que facilita la ejecución de LLM sin problemas de rendimiento.
Configuración de VPS de alta gama (modelos grandes / producción)
Para modelos LLM de gran tamaño (más de 30 mil millones de parámetros), se requiere una configuración VPS potente para garantizar un rendimiento estable y evitar fallos durante cargas de trabajo intensas. Estos modelos necesitan mucha memoria, gran capacidad de procesamiento y compatibilidad con GPU para funcionar de manera eficiente, especialmente en entornos de producción, aplicaciones de IA o uso continuo donde se gestionan múltiples solicitudes simultáneamente.
Descripción general de la configuración de gama alta
| Componente | Especificaciones recomendadas | Propósito |
| CPU | 16+ núcleos | Gestiona sin problemas tareas paralelas y operaciones del sistema. |
| RAM | 64-128 GB | Carga y ejecuta modelos grandes sin problemas de memoria. |
| Almacenaje | NVMe de más de 200 GB | Garantiza una carga rápida del modelo y un acceso rápido a los datos. |
| GPU | 24–80 GB VRAM / Multi-GPU | Permite una inferencia rápida y admite modelos grandes. |
Este tipo de configuración es la más adecuada para aplicaciones del mundo real donde el rendimiento, la escalabilidad y la fiabilidad son fundamentales.
Los mejores modelos LLM que puedes ejecutar en un VPS
La elección del LLM adecuado depende de los recursos de tu VPS y de tu caso de uso. Utilizar un modelo que se ajuste a tu sistema garantiza un rendimiento fluido, respuestas más rápidas y evita fallos o ralentizaciones innecesarias.
- Modelos pequeños: Rápido y ligero, ideal para pruebas y automatización básica.
- Modelos medianos: Rendimiento y precisión equilibrados, adecuados para la mayoría de los casos de uso reales.
- Modelos grandes: Salida de alta calidad pero requiere fuerza CPU, alto RAMy compatibilidad con GPU
Seleccionar el modelo adecuado ayuda a mantener la estabilidad y garantiza que su VPS funcione de manera eficiente sin problemas de rendimiento.
Software y herramientas necesarios
Para que los sistemas LLM funcionen de manera eficiente, se requiere un entorno de software configurado correctamente, ya que incluso un hardware potente puede fallar si la configuración no es correcta o no está optimizada.
- Sistema operativo (se recomienda Linux): Linux proporciona mayor estabilidad, rendimiento y compatibilidad para la mayoría de las herramientas y marcos de trabajo LLM.
- Entorno Python: La mayoría de los frameworks LLM dependen de Python, por lo que contar con la versión y las dependencias correctas es esencial para una ejecución sin problemas.
- Docker (opcional): Docker ayuda a crear un entorno consistente, lo que facilita la implementación y previene conflictos de dependencias.
- Herramientas LLM (Ollama, Hugging Face): Estas herramientas te permiten descargar, managey ejecutar modelos de manera eficiente en su VPS.
- Compatibilidad con GPU (CUDA y controladores): Si utiliza una GPU, es necesario configurar correctamente CUDA para habilitar la aceleración y mejorar el rendimiento.
Una configuración limpia y correcta garantiza que su LLM funcione sin problemas, evite errores y ofrezca un rendimiento constante sin interrupciones.
Guía paso a paso: Cómo ejecutar LLM localmente en un VPS
Configurar un modelo LLM en un VPS resulta sencillo si se sigue un proceso claro. El objetivo es preparar el servidor, instalar las herramientas necesarias y ejecutar el modelo en un entorno estable para que funcione de forma fiable y sin interrupciones.
Paso 1: Configura tu VPS
Comience por elegir un VPS con suficiente capacidad CPU, RAMy almacenamiento en función del tamaño de su modelo. Un proveedor estable como YouStable Puede ayudar a garantizar un rendimiento constante desde el principio, especialmente si planea ejecutar los modelos de forma continua.
Paso 2: Conéctese a su servidor (SSH)
Acceda a su VPS de forma segura mediante SSH Desde tu terminal: ssh usuario@tu-dirección-ip-del-servidor
Una vez conectado, podrá controlar su servidor de forma remota.
Paso 3: Actualizar el sistema
Antes de instalar nada, actualiza tu sistema para evitar problemas de compatibilidad: sudo apt update && sudo apt upgrade -y
Esto garantiza que todos los paquetes estén actualizados.
Paso 4: Instale las dependencias requeridas
Instala herramientas esenciales como Python y pip: sudo apt install python3 python3-pip -y
Estos requisitos son necesarios para la mayoría de los marcos y herramientas de LLM.
Paso 5: Instalar la herramienta LLM (Ejemplo: Ollama)
Ollama es una de las formas más sencillas de ejecutar LLM localmente: curl -fsSL https://ollama.com/install.sh | sh
Esto instala la herramienta y prepara su entorno.
Paso 6: Descargar y ejecutar un modelo.
Ahora puedes descargar y ejecutar un modelo directamente: ollama run llama2
El modelo comenzará a cargarse y luego aceptará las indicaciones.
Paso 7: Probar la salida del modelo.
Introduce una sencilla indicación para confirmar que todo funciona correctamente. Si el modelo responde correctamente, la configuración se ha realizado con éxito.
Paso 8: Mantener el modelo en funcionamiento
Para garantizar el funcionamiento continuo, ejecute el servicio en segundo plano o utilice herramientas como tmux, screen o servicios del sistema. Esto evita que el modelo se detenga cuando se desconecte de SSH.
Siguiendo estos pasos se garantiza que su LLM funcione sin problemas en un VPS con la configuración adecuada, estabilidad y un mínimo de errores.
Cómo acceder a su LLM
Una vez que su LLM esté funcionando en el VPS, podrá interactuar con él de diversas maneras, según cómo planee usarlo. Los métodos de acceso son flexibles, lo que le permite conectar su modelo con aplicaciones, herramientas de automatización o interfaces directas para su uso en entornos reales.
- Puntos finales de la API local: Puedes enviar solicitudes a tu modelo mediante llamadas a la API, lo cual es ideal para la integración con aplicaciones, scripts o sistemas de backend.
- Interfaces basadas en la web: Algunas herramientas proporcionan una interfaz de usuario sencilla en el navegador, lo que facilita probar las indicaciones y interactuar visualmente con el modelo.
- Integración con aplicaciones o herramientas de automatización: Puedes conectar tu LLM con flujos de trabajo, chatbots o servicios externos para automatizar tareas y crear aplicaciones reales.
Con estos métodos de acceso, su LLM se convierte en algo más que un modelo que se ejecuta en un servidor; se transforma en un sistema utilizable capaz de impulsar aplicaciones en tiempo real y automatización.
El mejor VPS para ejecutar LLM
Elegir el VPS adecuado es fundamental, ya que influye directamente en el rendimiento, la estabilidad y la fluidez con la que su LLM se ejecuta bajo diferentes cargas de trabajo. Un servidor bien equilibrado garantiza respuestas más rápidas, menos fallos y una mejor escalabilidad a medida que aumenta su uso.
Qué buscar en un VPS
| Elemento | POR QUÉ ES IMPORTANTE |
| CPU & RAM | Una gran capacidad de procesamiento y una memoria suficiente garantizan una ejecución fluida y evitan ralentizaciones. |
| Almacenamiento NVMe | Acceso a datos más rápido y carga de modelos más veloz en comparación con el almacenamiento tradicional. |
| Uptime | Un tiempo de actividad fiable mantiene su LLM funcionando de forma continua y sin interrupciones. |
| Escalabilidad organizacional | Te permite actualizar los recursos fácilmente a medida que aumenta tu carga de trabajo. |
Un proveedor confiable como YouStable Ofrece configuraciones VPS equilibradas que cumplen con estos requisitos, lo que facilita la ejecución eficiente de LLM sin problemas de rendimiento.
Problemas comunes y soluciones
Al ejecutar LLM en un VPS , es posible que se presenten algunos problemas comunes, la mayoría relacionados con limitaciones de recursos o problemas de configuración. Lo bueno es que estos problemas suelen ser fáciles de identificar y solucionar una vez que se comprende la causa.
| Problema | Causa comun | Solución |
| El modelo no se carga | Insuficiente RAM | Actualización RAM o utilizar un modelo más pequeño/cuantizado |
| Rendimiento lento | Débil CPU o sin aceleración de GPU | Utiliza uno mejor CPU o habilitar la compatibilidad con GPU |
| Choques frecuentes | Sobrecarga del sistema o alto uso de recursos | Reduzca la carga de trabajo o aumente los recursos del servidor. |
| Problemas de acceso | Puerto bloqueado o restricciones de firewall | Abra los puertos necesarios y verifique la configuración del firewall. |
La mayoría de los problemas se pueden resolver ajustando los recursos de su VPS, eligiendo el tamaño de modelo adecuado o corrigiendo la configuración básica.
Cómo mejorar el rendimiento de LLM en VPS
Mejorar el rendimiento de LLM en un VPS no se trata solo de aumentar los recursos, sino de optimizar la ejecución del modelo. Con el enfoque adecuado, se pueden lograr respuestas más rápidas, mayor estabilidad y un uso eficiente de los recursos, incluso sin actualizar el hardware de inmediato.
- Utilice modelos cuantizados (4 bits / 8 bits): Estos modelos consumen menos memoria y se ejecutan más rápido, lo que los hace ideales para entornos con recursos limitados.
- Elige el tamaño de modelo adecuado: Utilizar un modelo que se ajuste a la capacidad de tu VPS evita ralentizaciones y cargas innecesarias.
- Limitar las solicitudes simultáneas: Un número excesivo de solicitudes simultáneas puede sobrecargar el sistema, por lo que controlar la concurrencia ayuda a mantener un rendimiento estable.
- Utilice almacenamiento NVMe: Un almacenamiento más rápido reduce el tiempo de carga del modelo y mejora la capacidad de respuesta general.
- Supervise el uso del sistema periódicamente: Hacer un seguimiento de CPU, RAMy el uso de la GPU ayuda a identificar cuellos de botella antes de que causen problemas.
Una configuración bien optimizada combinada con una infraestructura VPS confiable, como por ejemplo: YouStableEsto puede mejorar significativamente el rendimiento y garantizar una ejecución fluida de LLM sin interrupciones.
Configuración local vs. VPS (Comparativa rápida)
La elección entre un sistema local y un VPS depende de cómo planees usar tu LLM. Una configuración local es ideal para pruebas y aprendizaje, mientras que un VPS ofrece mejor rendimiento, estabilidad y funcionamiento continuo para su uso en entornos reales.
| Configuración | Uso recomendado | Limitaciones |
| Sistema local | Pruebas, aprendizaje, modelos pequeños | Recursos limitados, sin disponibilidad 24/7, rendimiento más lento |
| VPS | Automatización, producción, escalabilidad | Mayor coste, pero mejor rendimiento y fiabilidad. |
Para un rendimiento constante y un uso a largo plazo, un VPS suele ser la opción más práctica y escalable.
¿Cuándo deberías actualizar tu VPS?
Deberías actualizar tu VPS cuando tu configuración actual empiece a limitar el rendimiento, la estabilidad o la capacidad de ejecutar modelos sin problemas. A medida que aumente tu carga de trabajo o pases a modelos más grandes, es posible que tus recursos actuales ya no sean suficientes.
- Tiempos de respuesta lentos: La CPU o la GPU no es lo suficientemente potente como para manejar la carga de trabajo de manera eficiente.
- Fallos o bloqueos frecuentes: Generalmente causado por insuficiencia RAM o VRAM
- No se pueden ejecutar modelos más grandes: Su hardware actual no admite tamaños de modelo superiores.
- Sobrecarga del sistema con múltiples tareas: No hay suficientes núcleos ni memoria para gestionar las solicitudes concurrentes.
- Alto consumo constante de recursos: CPU, RAMo la GPU se mantiene cerca de su capacidad máxima.
Actualizar en el momento adecuado garantiza una mayor velocidad, estabilidad y la capacidad de escalar su configuración LLM sin interrupciones.
Preguntas Frecuentes
1. ¿Puedo ejecutar LLM localmente en un VPS sin GPU?
Sí: , es posible ejecutar LLM pequeños (1B–7B) en un VPS sin GPU utilizando CPU solamente. Sin embargo, el rendimiento será más lento, especialmente durante la generación de respuesta. Para una mejor velocidad, estabilidad y soporte para modelos más grandes, una GPU con suficiente VRAM se recomienda encarecidamente.
2. ¿Cuánto cuesta ejecutar LLM en un VPS?
El costo depende de la configuración de su servidor. Las configuraciones VPS básicas para modelos pequeños son relativamente asequibles, mientras que las basadas en GPU o de alto rendimiento RAM Los servidores para modelos más grandes pueden ser más caros. La ventaja es que se evitan los costes recurrentes de la API y se obtiene un control total sobre el uso y la escalabilidad.
3. ¿Qué LLM es el mejor para ejecutar en un VPS?
El mejor LLM depende de los recursos de tu VPS:
• Los modelos pequeños funcionan bien en VPS con pocos recursos para realizar pruebas.
• Los modelos medianos son ideales para la automatización y aplicaciones reales.
• Los modelos grandes proporcionan una mayor precisión, pero requieren una GPU potente y alta velocidad. RAM
• Elegir un modelo que se adapte a su servidor garantiza un rendimiento óptimo y evita fallos.
4. ¿Es mejor ejecutar LLM en un VPS que usar APIs?
Ejecutar LLM en un VPS ofrece mayor control, privacidad y rentabilidad a largo plazo en comparación con las API. Si bien las API son más fáciles de usar inicialmente, conllevan límites de uso y costos recurrentes. Un VPS es ideal para cargas de trabajo continuas, flujos de trabajo personalizados y un control total del entorno.
Conclusión
A estas alturas, debería estar claro que el buen funcionamiento de un LLM depende menos del modelo en sí y más del entorno que elija. La mayoría de los problemas, como las respuestas lentas, los bloqueos o los fallos de ejecución, provienen de recursos limitados, no de la tecnología. Una vez que migre a un VPS con la configuración adecuada, esos problemas comenzarán a desaparecer y su configuración se volverá estable, predecible y mucho más fácil de gestionar. manage.
La clave está en adaptar tu servidor a tu carga de trabajo real y ampliarlo gradualmente a medida que aumentan tus necesidades. Cuando ejecutas LLM correctamente de forma local en un VPS, obtienes control total, mejor rendimiento y una configuración que puede manejar tareas del mundo real sin interrupciones. Con un VPS fiable como YouStable Con un entorno bien optimizado, su LLM se vuelve rápido, estable y está listo para un uso constante.