

Horké místo vs. teplé místo vs. studené místo . V rámci zotavení po havárii je horké místo plně vybavené, nepřetržitě synchronizované sekundární prostředí umožňující téměř okamžité přepnutí po selhání; teplé místo má předpřipravenou infrastrukturu s nedávnými kopiemi dat pro obnovu na úrovni hodin; studené místo je prázdné nebo minimální zařízení, kde se systémy znovu sestavují ze záloh, což trvá dny nebo i déle.
Výběr mezi horkým, teplým a studeným webem je jedním z nejdůležitějších rozhodnutí v oblasti obnovy po havárii. Váš výběr přímo ovlivňuje RTO (rychlost zotavení), RPO (kolik dat můžete ztratit), náklady a provozní složitost. Tato příručka vysvětluje klíčové rozdíly, kompromisy a jak si vybrat pro vaši firmu.
Jaká jsou horká, teplá a studená místa v roce 2026?
Lokality pro zotavení po havárii (DR) jsou alternativní fyzická nebo cloudová místa používaná k obnovení obchodních operací po výpadcích, kybernetických útocích nebo regionálních událostech.
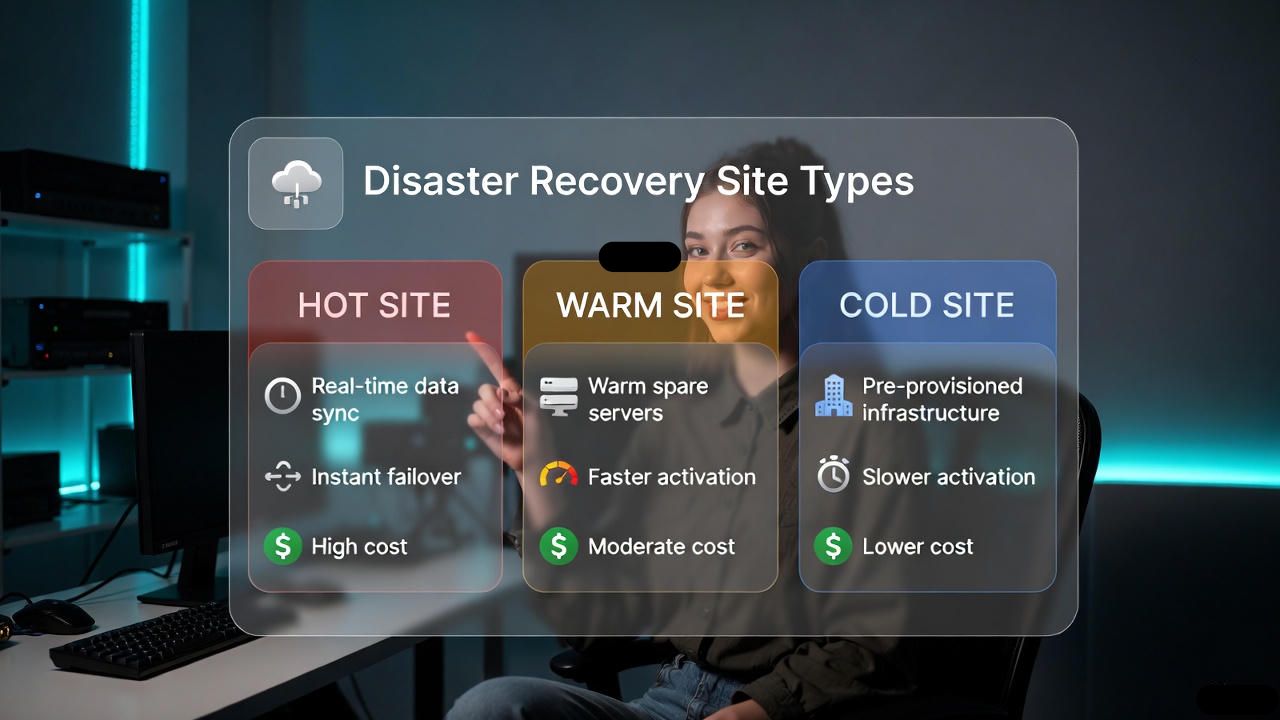
„Teplota“ odráží připravenost: čím je web teplejší, tím je lépe předpřipravený a synchronizovaný a tím rychlejší (a nákladnější) je jeho selhání.
Klíčové rozdíly na první pohled
- Cílový čas zotavení (RTO):
- Žhavé místo: sekund až minut
- Teplé místo: minuty až hodiny
- Chladné místo: dny až týdny
- Cíl bodu obnovy (RPO):
- Žhavé místo: téměř nula (sekundy)
- Teplé místo: nízká až střední (minuty až hodiny)
- Chladné místo: vysoká (hodiny až dny)
- Synchronizace dat:
- Hot: synchronní nebo vysokofrekvenční asynchronní replikace
- Teplý: pravidelná replikace nebo časté zálohy
- Studený: pouze zálohování (denní/týdenní), mimo pracoviště/média
- Připravenost infrastruktury:
- Hot: plně zřízený, aktivní nebo horký standby
- Teplý: částečně zřízeno, vyžaduje škálování při failoveru
- Studený: minimální nebo žádné; vyžadováno kompletní sestavení
- Provozní náklady:
- Hot: nejvyšší (výpočetní výkon, licence, průběžná synchronizace)
- Teplý: středně
- Studený: Nejnižší
- Frekvence testování:
- Hot: časté, automatizované cvičení
- Teplý: plánované testy failoveru
- Studený: pravidelné testy obnovy
- Nejlepší pro:
- Hot: kritické, regulované aplikace s nulovou tolerancí
- Teplý: důležité, ale nikoli životně/bezpečnostně kritické systémy
- Studený: archivní nebo nekritické úlohy
Hloubkový pohled na jednotlivé typy webů DR
Žhavé stránky
Aktivní pracoviště je plně funkční kopií vašeho produkčního prostředí. Výpočetní, úložné, síťové, bezpečnostní ovládací prvky a data jsou průběžně synchronizovány, což umožňuje okamžité nebo téměř okamžité přepnutí v případě selhání primárního pracoviště.

- Jak to funguje: synchronní replikace pro databáze a kritická úložiště; aktivní nebo aktivní pasivní clustery; automatizované přepnutí na záložní systém pomocí vyrovnávače zatížení, DNSnebo BGP.
- RTO/RPO: sekundy až minuty, u aplikací 1. úrovně často blízko nule.
- Klady: minimální prostoje, minimální ztráta dat, silný dodržování předpisů.
- Nevýhody: drahé (duplicitní prostředí, licencování), složité runbooky a monitorování.
- Nejlepší pro: finanční transakce, EMR ve zdravotnictví, SaaS v reálném čase, platební brány, e-commerce pokladna s vysokým SLA.
Teplé místo
Teplý server má předpřipravenou infrastrukturu (šablony virtuálních počítačů, rezervované instance, síťové a bezpečnostní základní hodnoty) a přijímá časté zálohy nebo asynchronní replikaci. Během failoveru spouštíte služby a používáte nejnovější data.
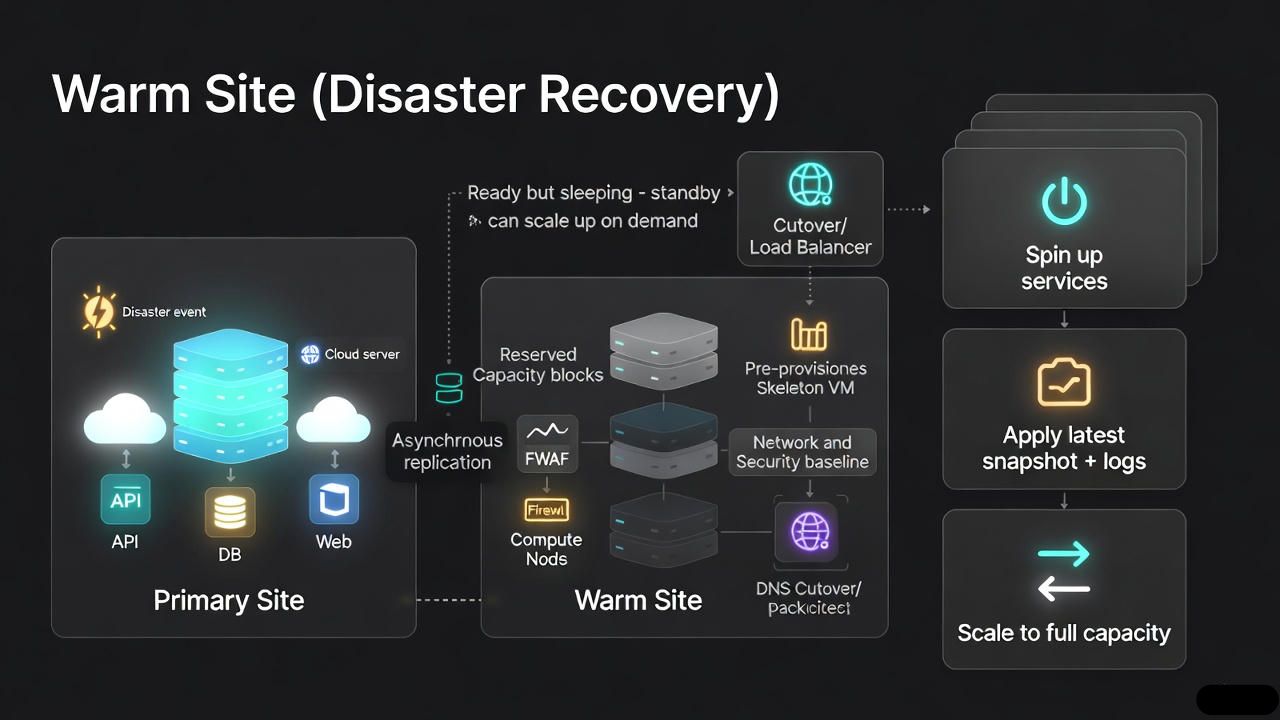
- Jak to funguje: plánované snímky a odesílání protokolů; infrastruktura jako kód (IaC) pro nasazení kapacity na vyžádání; částečná automatizace.
- RTO/RPO: minut až hodin, v závislosti na automatizaci a aktuálnosti dat.
- Klady: vyvážené náklady a rychlost; flexibilní škálování; jednodušší než aktivní web.
- Nevýhody: určité riziko prostojů a ztráty dat; spuštění orchestrace potřeby.
- Nejlepší pro: interní podnikové aplikace, CRM/ERP moduly, obsahové platformy, analytika, kde je tolerovatelný krátký výpadek.
Studené místo
Studené pracoviště poskytuje umístění nebo cloudový účet s minimálními předpřipravenými zdroji. Obnovujete systémy ze záloh a po havárii znovu sestavujete sítě, identity a aplikační stacky.
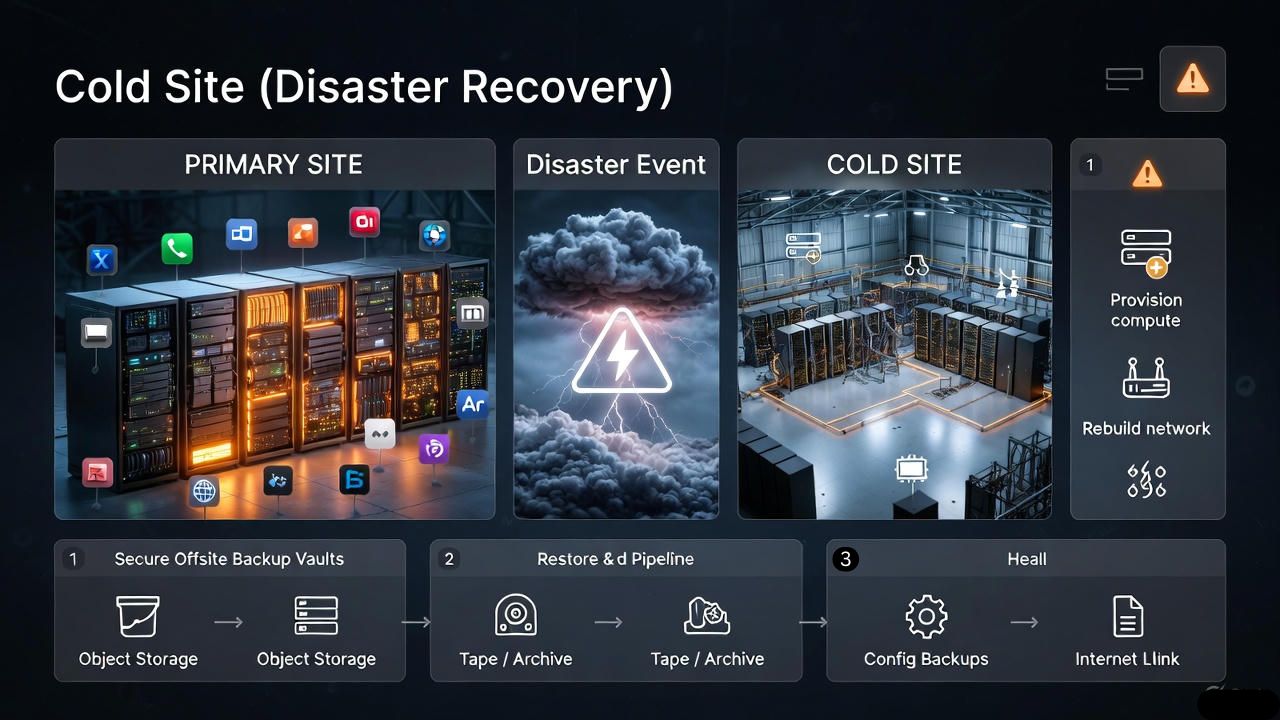
- Jak to funguje: zálohování mimo pracoviště (úložiště objektů, pásky), zálohování konfigurace, ruční zřizování v době havárie.
- RTO/RPO: dny až týdny; ztráta dat se rovná intervalu zálohování.
- Klady: nejnižší náklady, snadná údržba mezi testy.
- Nevýhody: nejdelší doba výpadku, potenciální konfigurační posun, vysoká lidská námaha během obnovy.
- Nejlepší pro: archivy, vývoj/testování, nekritické webové stránky, long tail služby.
RTO a RPO: Stanovení realistických cílů
Cílový čas obnovy (RTO) udává, jak rychle musíte službu obnovit. Cílový bod obnovy (RPO) udává, kolik dat si můžete dovolit ztratit. Definujte obojí pro každou aplikační vrstvu, nikoli pro každou společnost, a poté namapujte na typ lokality DR a rozpočet.
- Úroveň 1 (orientovaná na zákazníka, kritická pro tržby): RTO ≤ 15 minut; RPO ≤ 1 minuta → aktivní lokalita nebo prémiová teplá lokalita s replikací téměř v reálném čase.
- Úroveň 2 (důležité interní systémy): RTO 1–4 hodiny; RPO ≤ 1 hodina → teplé místo.
- Úroveň 3 (nekritická/archivní): RTO 24–72 hodin; RPO 24 hodin+ → chladné místo.
# Example DR mapping (simplified)
applications:
  checkout-api:
    rto: 5m
    rpo: 30s
    dr_site: hot
    replication: synchronous
  crm:
    rto: 2h
    rpo: 30m
    dr_site: warm
    replication: async_snapshots
  data_archive:
    rto: 48h
    rpo: 24h
    dr_site: cold
    replication: backups_only
On-Prem, cloud DR a DRaaS
Moderní obnova po havárii často využívá cloudové oblasti jako alternativní lokality. Veřejný cloud a DRaaS (obnova po havárii jako služba) snižují kapitálové výdaje, využívají automatizaci a poskytují geografickou diverzitu.
- Horký mrak: aktivní-aktivní napříč regiony s replikací databáze (např. více AZ/regionů), globální vyvažování zatíženía průběžnou synchronizaci dat.
- Teplé počasí: předpřipravené obrazy, replikované snímky úložiště, skupiny s automatickým škálováním; failover prostřednictvím DNS cutover a skriptované bootstrapy.
- Mrazivý mrak: ukládat šifrované zálohy do objektového úložiště a v případě potřeby znovu sestavovat pomocí IaC.
Dávejte si pozor na podrazy: poplatky za odchozí data během failoveru, licencování softwaru v sekundárních regionech, posun konfigurace a závislosti na identitě (SSO, adresářové služby). Ověřte zabezpečení a shodu s předpisy (ISO 22301, NIST SP 800-34, HIPAA, PCI DSS) napříč primárními i DR lokalitami.
Modelování nákladů a návratnost investic
Rozpočtování se netýká jen infrastruktury. Zahrnuje licence, replikaci, monitorování, sledovatelnost, testování, školení zaměstnanců a reakci na incidenty. Porovnejte to s očekávanými náklady na prostoje, abyste zdůvodnili požadovanou „teplotu“.
- Vzorec pro výpočet nákladů na prostoje (zjednodušený): Ztráta příjmů za hodinu + ztráta produktivity + sankce podle SLA + režie pro zotavení.
- Náklady na horké stránky: duplicitní výpočetní/úložné kapacity, nepřetržité připojení k síti, prémiové replikační funkce.
- Náklady na vyhřívané místo: rezervovaná kapacita nebo rozpínavé cloudové zdroje, plánovaná replikace, orchestrační nástroje.
- Náklady na studené stanoviště: úložiště pro zálohy, pravidelné testovací obnovení, pomalejší proces obnovy.
- Use the 3-2-1-1-0 pravidlo zálohování: 3 kopie, 2 média, 1 externí, 1 neměnné, 0 chyb po testování.
Jak si vybrat: Praktický rozhodovací rámec
- Proveďte analýzu dopadu na podnikání (BIA): kvantifikovat finanční a provozní dopad každé aplikace.
- Nastavení RTO/RPO podle úrovně: v souladu se zákazníky a regulačními povinnostmi.
- Mapování úrovní na typy webů: horké pro úroveň 1, teplo pro úroveň 2, studené pro úroveň 3.
- Ověření datových kanálů: Vyberte synchronní vs. asynchronní replikaci na základě RPO.
- Automatizace pomocí IaC a runbooků: snížit lidské chyby a urychlit zotavení.
- Testovací čtvrtletní test: provádět plánované převzetí služeb při selhání a dokumentovat mezery.
- Opakovat: upravujte teplotu DR podle změn ve vaší firmě nebo v prostředí hrozeb.
# DR Readiness Checklist (abbreviated)
- inventory_apps: complete
- classify_tiers: t1/t2/t3
- define_rto_rpo: approved_by_business
- choose_site_type: hot|warm|cold per app
- data_replication: configured_and_monitored
- infra_as_code: reproducible_builds
- runbooks: step_by_step_with_owners
- access_and_secrets: recoverable_and_secure
- failover_drills: quarterly_with_metrics
- postmortems: action_items_closed
Nemovitý Světové scénáře
- E-commerce s vysokou návštěvností: aktivní web pro mikroslužby pokladen, plateb a správy zásob; aktivní web pro CMS a vyhledávání; studený web pro historické reporty.
- SaaS platforma: horké pro autentizační a základní API; teplé pro analytiku; studené pro archivy a protokoly i po uchovávání dat.
- Poskytovatel lékařské péče: horké pro EMR a PACS; teplé pro plánování; studené pro staré zálohy obrazových dat (s přísnými kontrolami dodržování předpisů).
- Webové stránky malých a středních podniků: teplý web s nočními výpisy databáze a replikací obrázků; studený pro marketingové materiály.
- Vládní záznamy: teplá verze pro občanské portály a studená verze s neměnnými zálohami pro úložiště záznamů.
Doporučené postupy implementace
- Síť a DNS: Pro kontrolované a rychlé přepínání používejte globální vyvažovače zátěže, kontroly stavu a krátké doby TTL.
- Identity: zajištění adresářových služeb, vícefaktorové ověření (MFA) a tajných klíčů managereplikovat se nebo fungovat nezávisle na místě DR.
- Datum: zvolte replikaci, která odpovídá vašemu RPO; chraňte ji šifrováním, neměnností a zásadami WORM.
- Automatizace: sestavit pomocí Terraformu/CloudFormation a CI/CD; použít konfiguraci management pro kontrolu driftu.
- Pozorovatelnost: centralizovat protokoly a metriky v obou regionech; upozorňovat na zpoždění replikace a připravenost na přepnutí do selhání.
- Zabezpečení zrcadlit ovládací prvky (firewally, WAF, EDR, SIEM) napříč lokalitami; testovat reakci na incidenty spolu s DR.
- Testování: Procvičujte si úplné převzetí služeb při selhání, nejen testy komponent; ověřujte selhání vrácení zpět a částečných oblastí.
Nejčastější dotazy
Jaký je hlavní rozdíl mezi horkým, teplým a studeným místem?
Horký web je plně synchronizovaný a připravený k okamžitému spuštění, teplý web je částečně připravený a vyžaduje určitou aktivaci a studený web je minimální prostředí, kde se provádí restart ze záloh. Rozdíly se projevují v RTO/RPO a nákladech.
Který typ webu je nejdražší a proč?
Nejdražší jsou tzv. „hot sites“, protože na sekundárním pracovišti udržujete duplicitní infrastrukturu, průběžnou replikaci a licencování. Platíte za rychlost a minimální ztrátu dat, což vyžaduje nepřetržitě dostupné zdroje a sofistikovanou orchestraci.
Jaké typické RTO a RPO mohu očekávat pro každé pracoviště?
Horké místo: RTO sekundy až minuty; RPO blízké nule. Teplé místo: RTO minuty až hodiny; RPO minuty až hodiny. Studené místo: RTO dny až týdny; RPO se rovná vašemu intervalu zálohování (často 24 hodin nebo více).
Může cloud DR nahradit tradiční aktivní web?
Ano. Cloudové regiony mohou poskytovat horké, teplé nebo studené režimy s globálním vyvažováním zátěže a replikací mezi regiony. Mezi výhody patří elasticita a nižší kapitálové náklady, ale počítejte s náklady na odchozí data, licencování a paritou zabezpečení napříč regiony.
Jak se rozhodnu, jaký typ lokality pro DR moje firma potřebuje?
Spusťte analýzu dopadu na podnikání, nastavte RTO/RPO na úrovni aplikace a namapujte úrovně na typy pracovišť. Pokud je ztráta několika sekund dat nepřijatelná, zvolte aktivní režim; pokud tolerujete hodinu výpadku a ztrátu dat, může stačit teplý režim; pro nekritické systémy je cenově výhodný chladný režim.
Závěr
Horké servery poskytují nejrychlejší obnovu za nejvyšší náklady, teplé servery dosahují praktické rovnováhy a studené servery minimalizují náklady, ale prodlužují dobu prostojů. Začněte s obchodními požadavky, nikoli s technologiemi. Poté přizpůsobte teplotu serveru DR tak, aby odpovídala RTO/RPO, shodě s předpisy a rozpočtu, a testujte jej, dokud vás failover nezačne nudit.










