Snažíte se spustit LLM, ale nejste si jisti, jaký systém vlastně potřebujete? Možná je vaše nastavení pomalé, padá nebo nefunguje tak, jak jste očekávali. Pravdou je, že většina těchto problémů nastává, protože hardware a konfigurace nejsou správně sladěny s modelem, který používáte.
Jak tedy zjistit, co stačí a co ne? Přesně s tím vám tato příručka pomůže. Jasně pochopíte, jaké zdroje jsou potřeba pro různé velikosti modelů, jak zvolit správné nastavení a jak se vyhnout běžným chybám. Nakonec budete přesně vědět, co váš systém potřebuje k hladkému a spolehlivému běhu LLM.
Jaké jsou požadavky na LLM server?
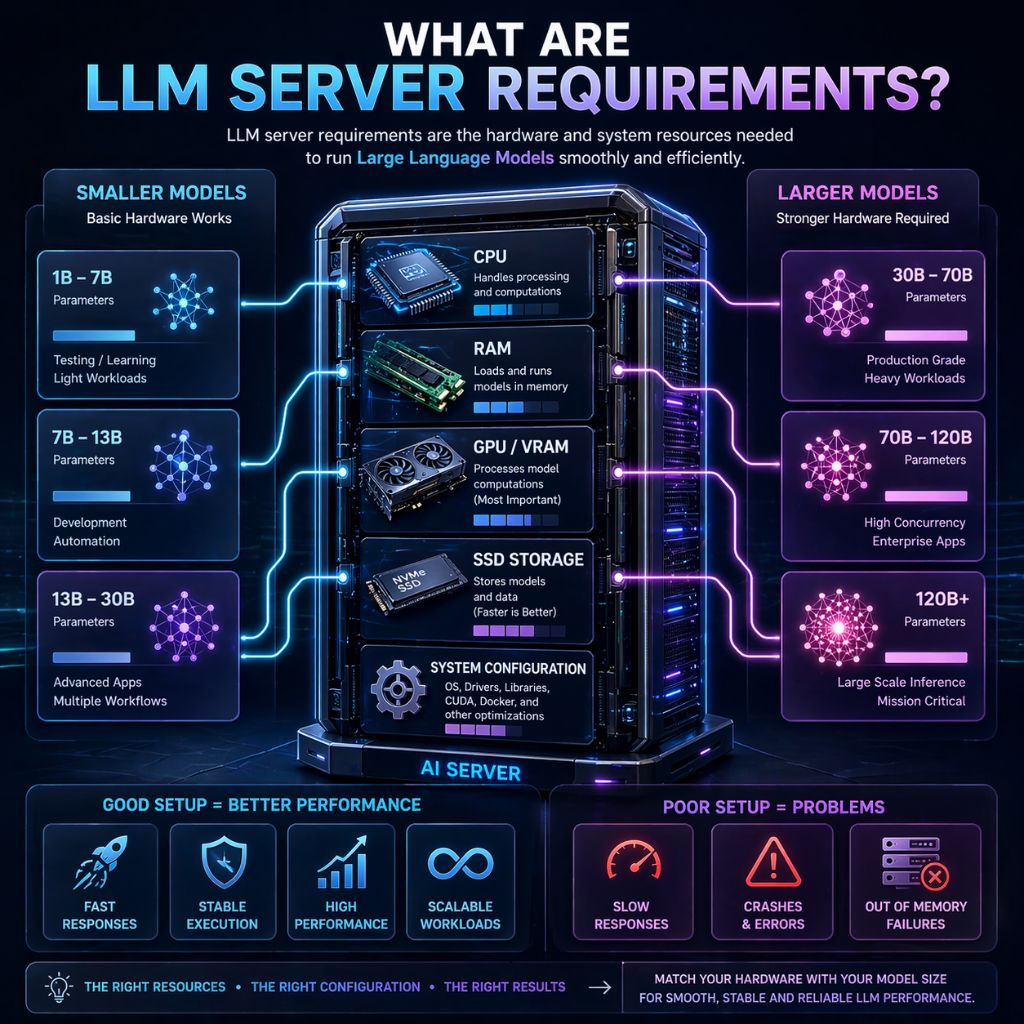
Požadavky na server LLM se vztahují k hardwarové a softwarové prostředky potřebné k efektivnímu spouštění rozsáhlých jazykových modelůMezi tyto požadavky patří CPU, RAM, GPU (VRAM), úložiště a konfigurace systému, což vše přímo ovlivňuje rychlost a plynulost výkonu modelu.
Přesné požadavky závisí na velikost modelu a váš případ použitíMenší modely mohou běžet na základních systémech, zatímco větší modely potřebují vysoký RAM a výkonné grafické karty.
Pokud není nastavení správně nakonfigurováno, můžete se setkat s pomalými odezvami, pády nebo neúspěšným spuštěním, zejména při velkém zatížení.
Minimální požadavky na server pro LLM (malé modely)
U malých LLM (s parametry okolo 1B–7B) je možné je spustit na základním systému, což je vhodné pro testování, učení a lehké pracovní zátěže. Tyto modely jsou méně náročné na zdroje, ale stále vyžadují stabilní prostředí, aby se zabránilo zpomalení nebo pádům během provádění.
Základní požadavky:
- CPU: 4–8 jader (moderní procesor pro stabilní výkon)
- RAM: 8–16 GB (minimálně pro plynulé načítání a spouštění modelů)
- Skladování: 20–50 GB SSD (rychlejší načítání ve srovnání s pevným diskem)
- Grafický procesor (volitelný): 4–8 GB VRAM (výrazně zlepšuje rychlost odezvy)
Toto nastavení funguje dobře pro začátečníky, ale bez grafické karty může být výkon nižší. Pro konzistentní používání nebo více pracovních postupů je lepší volbou upgrade zdrojů nebo přesun do serverového prostředí.
Doporučené požadavky na server (střední modely)
Pro středně velké LLM (s parametry okolo 7B–13B) je pro zajištění plynulého provozu vyžadováno vyváženější a výkonnější nastavení. Tato úroveň je ideální pro vývojáře, automatizované pracovní postupy a reálné aplikace, kde záleží na stabilitě a rychlosti.
Doporučené požadavky:
- CPU: 8–16 jader (efektivně zpracovává úlohy na pozadí a zpracování dat)
- RAM: 16–32 GB (zajišťuje načítání a běh modelů bez problémů s pamětí)
- Skladování: 50–100 GB SSD/NVMe (rychlejší přístup k datům a načítání modelů)
- GPU: 12–24 GB VRAM (nezbytné pro rychlé odvození a lepší výkon)
S touto konfigurací můžete spolehlivěji spouštět LLM, zpracovávat více pracovních postupů a snižovat latenci. Nabízí silnou rovnováhu mezi náklady a výkonem, takže je vhodná pro většinu praktických případů použití.
Požadavky na špičkové servery (velké modely)
Pro rozsáhlé LLM (parametry 30 miliard a více) potřebujete výkonný a dobře optimalizovaný server, protože tyto modely vyžadují pro plynulý chod velkou paměť, výkonné grafické karty a stabilní zpracování. Tento typ nastavení se používá hlavně pro produkční aplikace, nástroje umělé inteligence a velké pracovní zátěže, kde je výkon a spolehlivost zásadní.
Požadavky na špičkovou úroveň:
- CPU: 16–32+ jader (pro efektivní zpracování paralelních úloh a systémových operací)
- RAM: 64–128 GB+ (pro načítání a spouštění velkých modelů bez problémů s pamětí)
- Skladování: 200+ GB NVMe SSD (rychlé načítání a lepší rychlost zpracování dat)
- GPU: 24–80 GB VRAM (nebo nastavení s více GPU pro rozsáhlou inferenci)
Tato úroveň konfigurace poskytuje stabilní výkon, rychlejší dobu odezvy a schopnost zpracovávat více požadavků bez pádů. Je nejvhodnější pro uživatele, kteří potřebují konzistentní výstup, škálovatelnost a plynulé provádění rozsáhlých modelů umělé inteligence.
GPU vs. CPUNa čem záleží více pro LLM?
Při spouštění LLM, obojí CPU a grafický procesor jsou důležité, ale jejich role se liší. CPU manages úkoly na systémové úrovni, jako je zpracování procesů a požadavků, zatímco GPU provádí náročné výpočty potřebné pro odvozování modelu a generování odpovědí. Protože LLM se spoléhají na paralelní zpracování, má výkon GPU mnohem větší vliv na celkový výkon.
Systém bez grafické karty (GPU) může stále spouštět malé modely, ale bude výrazně pomalejší a méně efektivní. Pro lepší rychlost, stabilitu a schopnost spouštět větší modely je GPU (zejména VRAM) se stává nejdůležitějším faktorem.
Srovnávací tabulka
| Složka | Role v LLM | Dopad na výkon |
| CPU | Zvládá systémové operace a úlohy na pozadí | Střední |
| GPU | Zpracovává výpočty modelu a generuje výstup | Vysoký |
| VRAM | Ukládá model za běhu a ovlivňuje podporu velikosti | Velmi vysoko |
RAM a vysvětlení požadavků na skladování
RAM hraje kritickou roli spouštění LLM, protože se používá k načítání a zpracování modelu během provádění. Pokud váš systém nemá dostatek RAM, model se nemusí spustit, může se během používání zhroutit nebo se extrémně zpomalit. Větší modely vyžadují více paměti, a proto RAM přímo ovlivňuje stabilitu a výkon.
Úložiště je stejně důležité, zejména pro práci s velkými soubory modelů. SSD nebo NVMe úložiště zajišťuje rychlejší načítání a plynulejší přístup k datům ve srovnání s tradičními pevnými disky. I když úložiště přímo neovlivňuje rychlost inference, pomalé úložiště může zpozdit načítání modelu a snížit celkovou efektivitu.
Rozdělení klíčů
| Složka | Role v LLM | Dopad |
| RAM | Načítá a spouští modely v paměti | Vysoká (ovlivňuje stabilitu a výkon) |
| SSD/NVMe | Ukládá modely a data | Střední (ovlivňuje rychlost načítání) |
| Velikost úložiště | Určuje, kolik modelů můžete uložit | Důležité pro škálovatelnost |
Vyvážená kombinace dostatečného RAM a rychlé úložiště zajišťuje, že váš LLM poběží hladce bez zpoždění nebo neočekávaných selhání.
Softwarové požadavky pro spouštění LLM
Spouštění LLM se netýká jen hardwaru; pro stabilní a efektivní výkon je stejně důležité i správné softwarové prostředí. Správně nakonfigurovaný systém zajišťuje, že se modely načítají správně, běží hladce a vyhýbají se běžným chybám souvisejícím se závislostmi nebo problémy s kompatibilitou.
Většina nastavení LLM se spoléhá na kombinaci podpory operačního systému, běhových nástrojů a požadovaných knihoven. Výběr správného softwarového balíčku pomáhá zlepšit výkon, zjednodušuje nasazení a usnadňuje... manage modely a pracovní postupy.
Základní softwarové požadavky:
- Operační systém: Linux (doporučeno pro stabilitu a výkon), podporovány jsou také Windows a macOS
- Runtime prostředí: Python (pro většinu frameworků a nástrojů LLM)
- Kontejnerizace: Docker (pro snadné nasazení a konzistenci prostředí)
- Nástroje pro LLM: Ollama, Hugging Face Transformers nebo podobné frameworky
- Podpora GPU: CUDA a ovladače (vyžadované pro akceleraci GPU)
Se správným nastavením softwaru se můžete vyhnout problémům s kompatibilitou, zvýšit rychlost provádění a spolehlivě spouštět LLM v různých prostředích.
Lokální nastavení vs. VPS hosting pro LLM
Při provozování LLM je lokální systém vhodný pro testování a drobné úkoly, ale je omezen hardwarem a dostupností, zatímco VPS poskytuje vyšší výkon, spolehlivost a nepřetržitý provoz pro náročné úlohy.
Srovnávací tabulka
| Nastavení | nejlepší | Omezení |
| Místní systém | Testování, učení, malé modely | Omezené zdroje, žádná nepřetržitá dostupnost |
| VPS / Server | Automatizace, výroba, škálování | Vyšší cena, ale lepší výkon |
Výběr správného nastavení závisí na vašich potřebách, ale pro stabilní výkon a dlouhodobé používání je VPS obecně praktičtější volbou.
Nejlepší nastavení serveru pro LLM (praktické konfigurace)
Výběr správného nastavení serveru závisí na vaší pracovní zátěži, velikosti modelu a očekávaném výkonu. Vyvážená konfigurace zajišťuje plynulý chod, zabraňuje pádům a poskytuje konzistentní výsledky bez zbytečných nákladů. Místo používání náhodných specifikací je lepší řídit se praktickými nastaveními založenými na reálných případech použití.
Nastavení pro vstupní úroveň (testování a učení):
- CPU: 4–8 jádra
- RAM: 8 - 16 GB
- Skladování: 50 GB SSD
- GPU: Volitelné (základní nebo žádné)
Toto nastavení je vhodné pro malé modely a základní experimenty, ale výkon bude omezený.
Nastavení středního rozsahu (vývoj a automatizace):
- CPU: 8–16 jádra
- RAM: 16 - 32 GB
- Skladování: 100GB SSD/NVMe
- GPU: 12–24 GB VRAM
Ideální pro vývojáře, API a automatizované pracovní postupy, nabízí dobrou rovnováhu mezi výkonem a cenou.
Špičkové nastavení (produkce a vysoká pracovní zátěž):
- CPU: 16+ jader
- RAM: 64 GB+
- Skladování: 200+ GB NVMe
- GPU: 24–80 GB VRAM nebo více GPU
Nejlepší pro velké modely, aplikace umělé inteligence a zpracování více požadavků se stabilním výkonem.
Výběr správné konfigurace zajistí, že vaše LLM bude běžet efektivně bez zpomalení, což usnadňuje škálování s rostoucí pracovní zátěží.
Časté chyby, kterým se vyhnout při nastavování LLM serverů
Nastavení LLM serveru se může zdát jednoduché, ale malé chyby v konfiguraci nebo výběru hardwaru mohou vést ke špatnému výkonu, pádům nebo selhání modelu. Většina problémů není způsobena samotným modelem, ale nesprávnými rozhodnutími o nastavení, která omezují efektivitu a stabilitu.
Obyčejné chyby:
- Výběr nízké RAM systémy: Nedostatek paměti brání správnému načítání modelů a způsobuje pády
- Ignorování požadavků na GPU: Provádění LLM bez řádného VRAM vede k pomalému výkonu a omezením
- Používání velkých modelů na slabém hardwaru: To má za následek neúspěšné spuštění nebo extrémně pomalé odezvy.
- Špatná konfigurace prostředí: Chybějící proměnné, nesprávné nastavení Dockeru nebo problémy se závislostmi mohou systém narušit.
- Neoptimalizování modelů: Přeskočení kvantizace nebo optimalizace zbytečně zvyšuje využití zdrojů.
- Ignorování rychlosti úložiště: Použití HDD místo SSD/NVMe zpomaluje načítání a výkon modelu
Vyhnutí se těmto chybám zajistí, že vaše nastavení LLM bude fungovat hladce, efektivně a stabilně i při větším zatížení.
Jak optimalizovat výkon LLM
Optimalizace výkonu LLM je nezbytné, pokud chcete rychlejší odezvy, stabilní běh a efektivní využití zdrojů. I s dobrým hardwarem může špatná konfigurace nebo neefektivní pracovní postupy zpomalit váš systém a způsobit selhání. Cílem je snížit zátěž, manage správně využívat zdroje a zajistit hladký chod modelu za různých podmínek.
Nejúčinnější vylepšení plynou z kombinace optimalizace hardwaru, ladění softwaru a návrhu pracovních postupů. Provedením malých, ale praktických změn můžete výrazně zvýšit rychlost, snížit latenci a vyhnout se běžným problémům s výkonem.
Klíčové optimalizační metody (vysvětlení):
- Použijte kvantizované modely (4bitové / 8bitové):
Kvantizace zmenšuje velikost modelu a snižuje využití paměti. To umožňuje spouštět větší modely na omezeném hardwaru a zároveň zlepšovat rychlost odezvy. - Vyberte správnou velikost modelu: Vyhněte se spouštění zbytečně velkých modelů pro jednoduché úkoly. Menší modely jsou rychlejší a efektivnější, zejména pro automatizaci nebo základní případy použití.
- Optimalizace využití GPU: Zajistěte si GPU VRAM je pro daný model dostatečné. Spuštění modelů, které překračují VRAM způsobuje pády nebo přechod na pomalejší CPU provedení.
- Omezení souběžných spuštění: Spouštění příliš velkého počtu požadavků najednou může přetížit váš systém. Říďte souběžnost, abyste udrželi stabilní výkon a zabránili zpomalení.
- Použijte rychlejší úložiště (NVMe SSD): Úložiště NVMe zkracuje dobu načítání modelu a zlepšuje rychlost přístupu k datům, což pomáhá k rychlejšímu provádění, zejména u velkých modelů.
- Povolit systém front (rozšířené nastavení): Používání systému založeného na frontách pomáhá manage efektivně vyřizovat více požadavků namísto přetížení serveru najednou.
- Použít externí databázi (PostgreSQL): V produkčních prostředích zvyšuje použití PostgreSQL namísto výchozího úložiště výkon, zejména při vysokých pracovních zátěžích a vícenásobném spuštění.
- Udržujte životní prostředí čisté a aktuální: Pravidelně aktualizujte nástroje, závislosti a ovladače LLM, abyste se vyhnuli chybám, problémům s kompatibilitou a poklesům výkonu.
- Sledování protokolů a metrik výkonu: Protokoly pomáhají identifikovat pomalé uzly, selhávající procesy nebo úzká hrdla, což vám umožňuje opravit problémy dříve, než ovlivní výkon.
- Optimalizace návrhu pracovního postupu:: Rozdělte složité pracovní postupy na menší části a odstraňte zbytečné kroky. Tím se sníží zátěž a zrychlí provádění.
Rychlý přehled optimalizace
| Oblast | Společný problém | Optimalizace |
| Model Velikost | Příliš velký pro systém | Používejte menší nebo kvantované modely |
| Využití GPU | Nedostatečné VRAM | Přizpůsobení velikosti modelu kapacitě GPU |
| Prováděcí zatížení | Příliš mnoho požadavků | Omezení souběžnosti nebo použití fronty |
| Skladování | Pomalý přístup k datům | Použijte NVMe SSD |
| Workflow | Složitá logika | Zjednodušte a rozdělte pracovní postupy |
| životní prostředí | Zastaralé nastavení | Aktualizujte software |
Použitím těchto strategií můžete výrazně zlepšit výkon LLM, díky čemuž bude váš systém rychlejší, stabilnější a schopen zvládat reálné pracovní zátěže bez přerušení.
Kdy byste měli upgradovat svůj LLM server?
Pokud vaše nastavení LLM začne vykazovat trvalé problémy s výkonem, jako jsou pomalé odezvy, pády nebo potíže se zpracováním více úloh současně, obvykle to znamená, že váš stávající hardware již není dostatečný. S rostoucí velikostí modelu, využitím nebo pracovním zatížením je upgrade serveru nezbytný pro udržení stability, rychlosti a spolehlivého běhu bez přerušení.
Tabulka indikátorů upgradu
| Problém | Co to znamená | Akce upgradu |
| Časté pády | Nedostatek RAM nebo VRAM | Navýšit RAM / upgrade grafické karty |
| Pomalá doba odezvy | Slabý CPU nebo grafický procesor | Upgradujte GPU nebo CPU |
| Nelze provozovat větší modely | Hardwarové omezení | Použijte vyšší VRAM GPU |
| Přetížení systému více úkoly | Nízké zdroje | Zvyšte počet jader a RAM |
| Vysoký CPU využití, nízké využití GPU | Žádná pořádná akcelerace GPU | Přidat nebo upgradovat grafickou kartu (GPU) |
| Problémy s ukládáním | Pomalé nebo nedostatečné úložiště | Přejděte na NVMe SSD |
Aktualizace ve správný čas zajišťuje hladký chod vašeho LLM, zvládání větších úloh a konzistentní výkon bez selhání.
Nejčastější dotazy
Mohu spustit LLM bez GPU?
Ano, můžete spouštět malé LLM na CPU pouze, ale výkon bude mnohem pomalejší. Úlohy, jako je generování odpovědí, zaberou podstatně více času a větší modely se nemusí spustit vůbec. Pro lepší rychlost a stabilitu se důrazně doporučuje grafická karta (GPU).
Kolik RAM stačí pro vedení LLM?
Záleží na velikosti modelu. Malé modely mohou běžet na 8–16 GB. RAMStřední modely vyžadují 16–32 GB a velké modely 64 GB nebo více. Nedostatečné RAM často vede k pádům nebo neúspěšnému načítání modelu.
Co je důležitější pro výkon LLM, GPU nebo CPU?
Obojí je důležité, ale GPU hraje ve výkonu větší roli. CPU zpracovává systémové operace, zatímco GPU zpracovává výpočty modelů. Výkonný GPU s dostatečným VRAM výrazně zvyšuje rychlost a efektivitu.
Mám pro spuštění LLM používat lokální systém nebo VPS?
Lokální systém je vhodný pro testování a učení, ale má omezení ve výkonu a provozuschopnosti. Pro nepřetržité používání, automatizaci nebo produkční zátěže poskytuje VPS nebo dedikovaný server lepší stabilitu, škálovatelnost a spolehlivost.
Závěr
Pokud jste se dostali až sem , jedna věc je jasná, nyní chápete, že spuštění LLM není jen o instalaci modelu a očekávání, že bude fungovat perfektně. Jde o výběr správného hardwaru, správné nastavení prostředí a zajištění toho, aby váš systém odpovídal vaší skutečné pracovní zátěži. Jakmile jsou tyto prvky sladěny, většina běžných problémů, jako je pomalá rychlost, pády nebo neúspěšné spuštění, jednoduše zmizí.
Hlavní ponaučení je jednoduché: začněte s tím, co odpovídá vašemu aktuálnímu případu použití, ale myslete dopředu. Pokud testujete, stačí základní nastavení. Pokud vytváříte reálné aplikace nebo zpracováváte nepřetržitou pracovní zátěž, chytřejší volbou se stává silnější server nebo VPS. Když je vaše nastavení správně optimalizováno, LLM se stanou rychlými, stabilními a spolehlivými, přesně tak, jak mají fungovat.